写在前面
10 月 31 日晚,DeepSeek Harness 团队发表技术文章《Super-agent 设计探索:迈向更自主的 Agent 系统》,同时在 GitHub 公开了研究原型 deepseek-ai/dsh-superagent-prototype。文章的核心判断很直白:个人助手和团队 Agent 的多任务上限,卡在人的注意力上,而不是模型能力上。 为此他们给出了一套架构思路:常驻的 Router 层负责人类交互与分派,上下文隔离的 Worker 层负责执行;事件驱动、按 Thread 订阅路由;允许 Agent 在后台「投机执行」;再用一个独立的 Watchdog 会话做外部控制回路。
原型 README 也把边界写得很清楚:它是「仅供参考的研究原型」,不是 DeepSeek 正式产品,与内部版本和文章描述并不完全一致,文中部分设计是未来方向、原型并未实现。
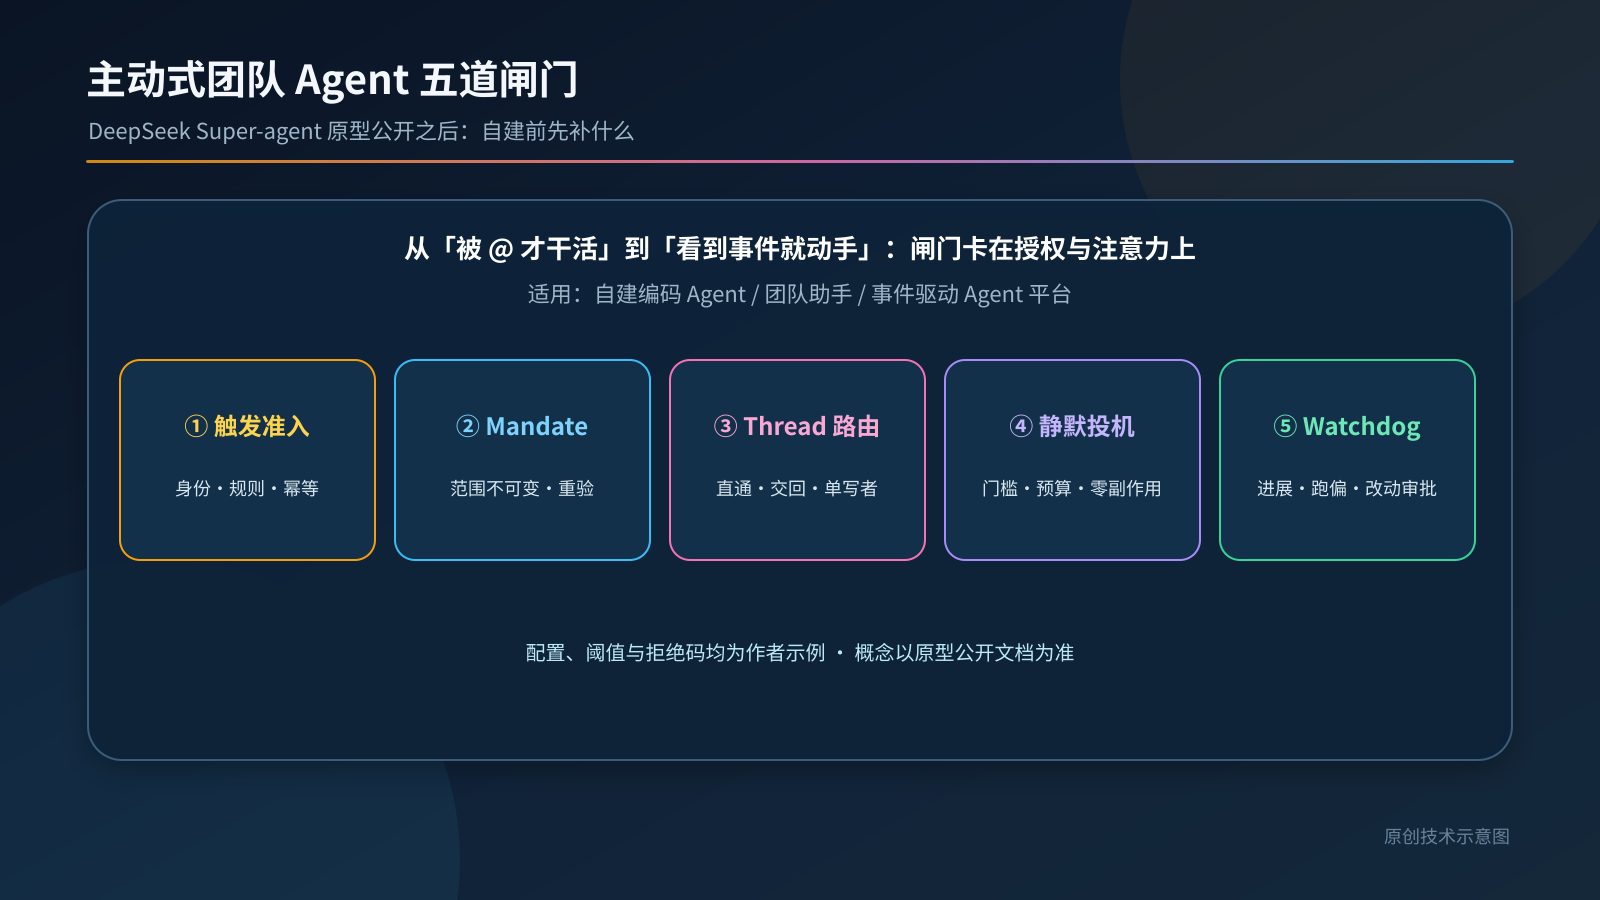
所以这篇不复述新闻,也不评测原型能不能直接上生产,而是回答一个更实际的问题:如果你也想让自己的 Agent 从「被 @ 才干活」变成「看到群聊/Issue/CI 事件就主动动手」,上线之前要先补哪几道闸门?
我把它拆成五道:
- 触发准入:哪些事件、哪些人、哪些规则可以让 Agent 开工;
- Mandate 授权:开工时授予了多大范围,范围能不能被悄悄扩大;
- Thread 路由:后续事件走直通还是重新研判,多个 Worker 撞在同一个 PR 上怎么办;
- 静默投机:后台预做的结果什么时候交付、什么时候丢弃,算力怎么封顶;
- Watchdog:进程活着不等于任务在推进,外部控制回路如何发现「卡死」与「跑偏」。
说明:下文 YAML、JSON、Python、状态码与阈值都是作者为说明思路写的示例,不是 DeepSeek 原型的真实配置;涉及原型概念(Source / Trigger / Eval / Ticket / Mandate / Thread)时,以其仓库
docs/001-domain.md的公开定义为准。
一、先看清它改变了什么
传统编码 Agent(包括大多数 IDE 内 Agent)的交互模型是:人开一个 Session → 下指令 → Agent 执行 → 人验收。Session 是用户手里的东西,用户自己决定开几个、往哪个里说话。
Super-agent 文章把这个关系反过来:Session 成了系统的实现细节。按文章与仓库文档的描述,一条消息的旅程大致是:
Source(GitHub / 飞书等事件源)→ Trigger(不可变事件)→ Eval(两层研判:gate + assessment)→ Ticket(带 Mandate 的授权工作单元)→ Assignment(绑定到某个 Worker 执行)→ Channel(回写到原会话,比如 PR 或群消息)
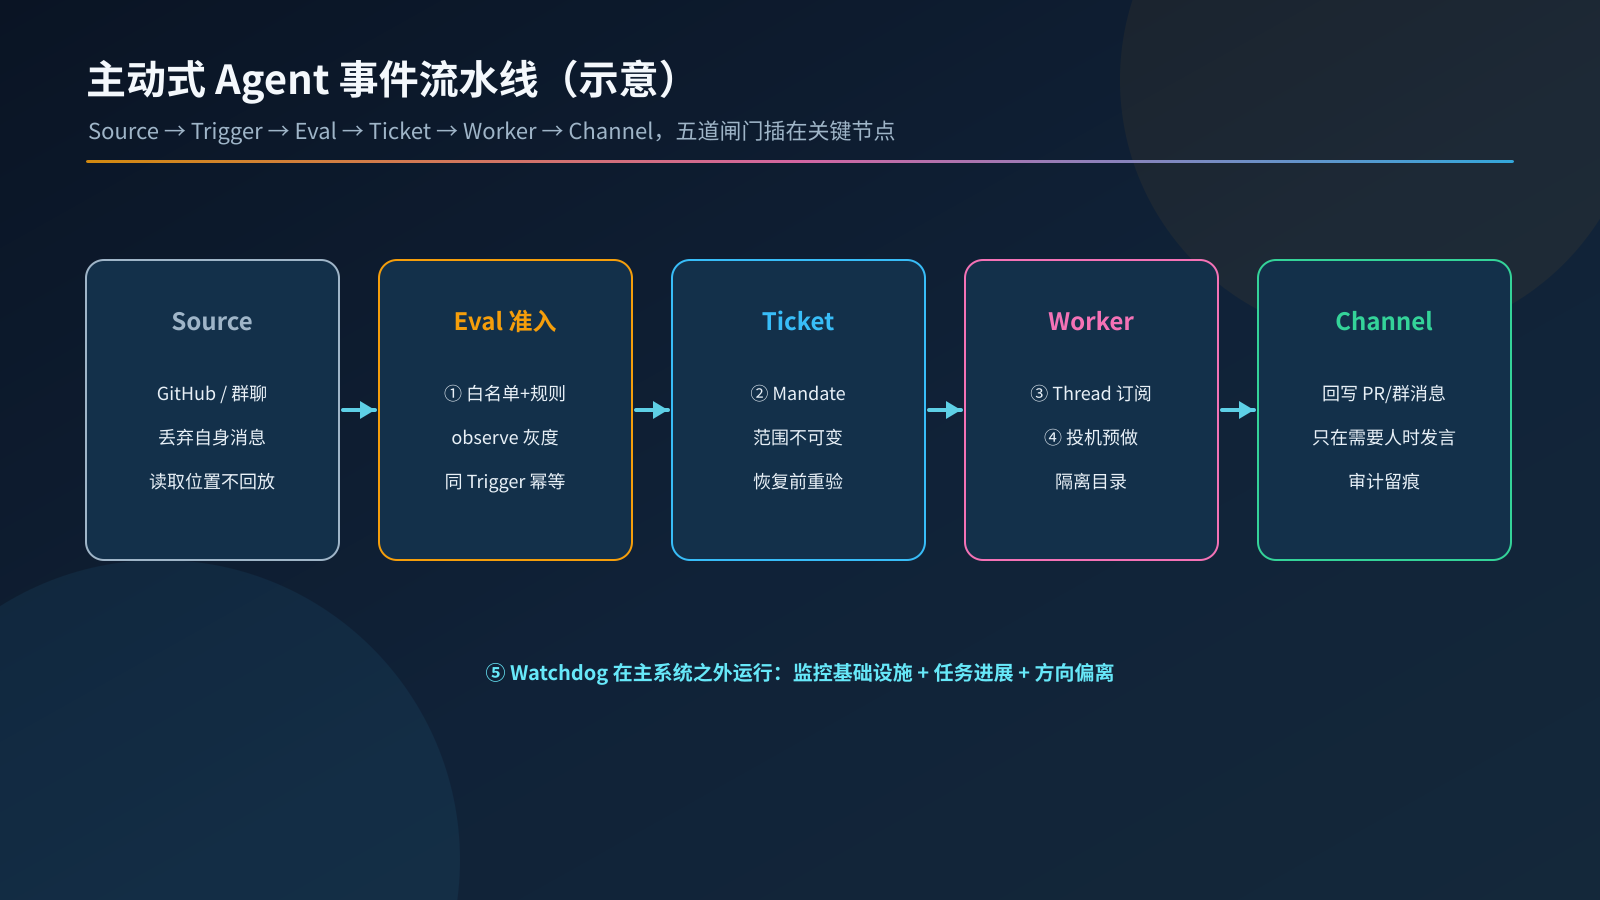
这带来的工程变化有三个:
| 变化 | 以前 | 主动式之后 | 风险点 |
|---|---|---|---|
| 谁触发工作 | 明确发指令的人 | 事件 + 规则,可能没人 @ | 误触发、被人借道触发 |
| 谁替谁说话 | Agent 在人开的会话里回答 | Agent 主动在群/PR 里发言 | 打扰、刷屏、越权回复 |
| 工作何时结束 | 人关掉 Session | Ticket 可被新消息恢复 | 授权残留、范围漂移 |
原型 README 里有一句话值得每个自建团队贴在墙上:一个能代表整个团队行动的 Agent,也能浪费整个团队的注意力,所以它只在被请求或团队写下的规则允许时行动,只在有人必须行动或能用上结果时发言。下面五道闸门,本质上都是把这句话落成代码。
二、闸门 ①:触发准入——谁、什么事件能让它开工
主动式 Agent 最容易出事的地方不是执行,而是开工条件太宽。公开文档里有几条规则可以直接借鉴:
- Source 在事件进入领域之前就丢弃 bot 自己发的消息和不在监听范围内的事件(防止自激循环);
- Source 保存读取位置,重启不得重放事件;
- 同一个 Trigger 被接受两次,只能产生一个 Ticket(幂等);
- Policy 规定「谁能通过这个 Source 发起工作」,且不同 Source 上的身份永不互相映射。
最后一条很容易被忽略。很多团队会图方便把「飞书里的张三」和「GitHub 上的 zhangsan」当成同一个人做授权——一旦某个平台账号被冒用,授权就跨平台扩散了。
示例准入配置(作者示例):
# policy.yaml —— 作者示例,非原型真实格式
policy_version: 2026-11-02.1
sources:
  github:
    allow_originators: [alice-gh, bob-gh]      # 只认本 Source 身份
    listen: [mention, assigned_issue, ci_failed_on_default]
    drop_self: true
  feishu:
    allow_originators: [ou_alice, ou_bob]      # 不与 github 身份互映射
    listen: [mention, rule:bug_report_keyword]
    drop_self: true
accept_mode: observe   # observe = 只研判不执行,灰度期先跑这个
准入判定建议输出结构化的拒绝码,而不是一句「我不处理」:
| 拒绝码(示例) | 含义 | 处置 |
|---|---|---|
TRIG_SELF_LOOP |
事件由本 bot 产生 | 静默丢弃 |
TRIG_REPLAY |
读取位置之前的旧事件 | 静默丢弃,记审计 |
TRIG_ORIGINATOR_DENY |
发起人不在本 Source 白名单 | 不开工,可选一次性提示 |
TRIG_RULE_UNMATCHED |
未被 @,也没命中书面规则 | 不开工,Router 仅观测 |
TRIG_DUP_ACCEPT |
同一 Trigger 重复接受 | 返回已有 Ticket |
灰度建议:先用 observe 模式跑一到两周,只记录「如果放开会开哪些工」,人工抽查误触发率,再切到真正执行。
三、闸门 ②:Mandate 授权——开工时给多大范围
原型文档把 Mandate 定义为「一次接受所授予的东西」:Policy 版本、范围(scope)、强度、命中的规则、发起人在该 Source 上的身份,以及 Source 是怎么收到这个 Trigger 的。几条关键规则:
- Mandate 不可变;范围更大就要开新 Ticket;
- Ticket 结束不等于 Mandate 结束,只有人的 stop 能撤回,Policy 不再支持时会被吊销;
- 已结束的 Ticket 恢复之前,要按当前 Policy 重新校验 Mandate;
- Policy 变更会作用到正在跑的 Eval:规则变了,进行中的研判要丢弃。
翻译成自建系统的闸门,就是三件事:
- 范围写死在授权里:例如「只读复现」「可开分支提 PR」「可合并」是三档强度,不能在执行中自己升档;
- 恢复要重验:两周前因为一句「帮我看下这个 bug」开的 Ticket,今天被新评论唤醒时,发起人可能已经离开项目、规则可能已经改版;
- Policy 变更要传播:新规则发布后,正在执行的 Assignment 要收到通知,由它决定继续、收缩还是停下。
# 作者示例:恢复 Ticket 前的 Mandate 重验
def can_resume(ticket, policy_now, event):
    m = ticket.mandate
    if ticket.stopped_by_human:
        return False, "MANDATE_STOPPED"
    if not policy_now.allows(m.source, m.originator):
        return False, "MANDATE_REVOKED_BY_POLICY"
    if event.requested_scope > m.scope:          # 想做的超过当初授权
        return False, "MANDATE_SCOPE_EXCEEDED"   # 走新 Ticket,重新研判
    return True, "OK"
一个实用的检查:随机抽 20 个已结束的 Ticket,人工问一句「如果今天被唤醒,它还有权做这件事吗」。答不上来的,说明 Mandate 字段不够。
四、闸门 ③:Thread 路由——直通还是重新研判
文章描述的路由分两条路径:Worker 创建后订阅对应 Thread,同一 Thread 后续事件直通 Worker(Fast Path);未被订阅的新事件由 Router 研判分派(Slow Path)。Router 仍能观测所有事件以掌握全局状态,但不重复转发。
这个设计省掉了大量 Router 调用,但也带来两个需要闸门的问题:
- 范围漂移:PR 评论里有人顺手提了一个完全不同的需求,直通给 Worker 后,Worker 可能就「顺便做了」。文章给出的出路是 Worker 可以取消订阅或交回 Router 重新分派——自建时应把它做成强制检查,而不是靠模型自觉;
- 共享环境冲突:多个 Worker 都订阅了同一个 PR 时会收到相同事件。文章的思路是让它们各自发现并解决冲突,少数跨任务协同由 Router 中转。
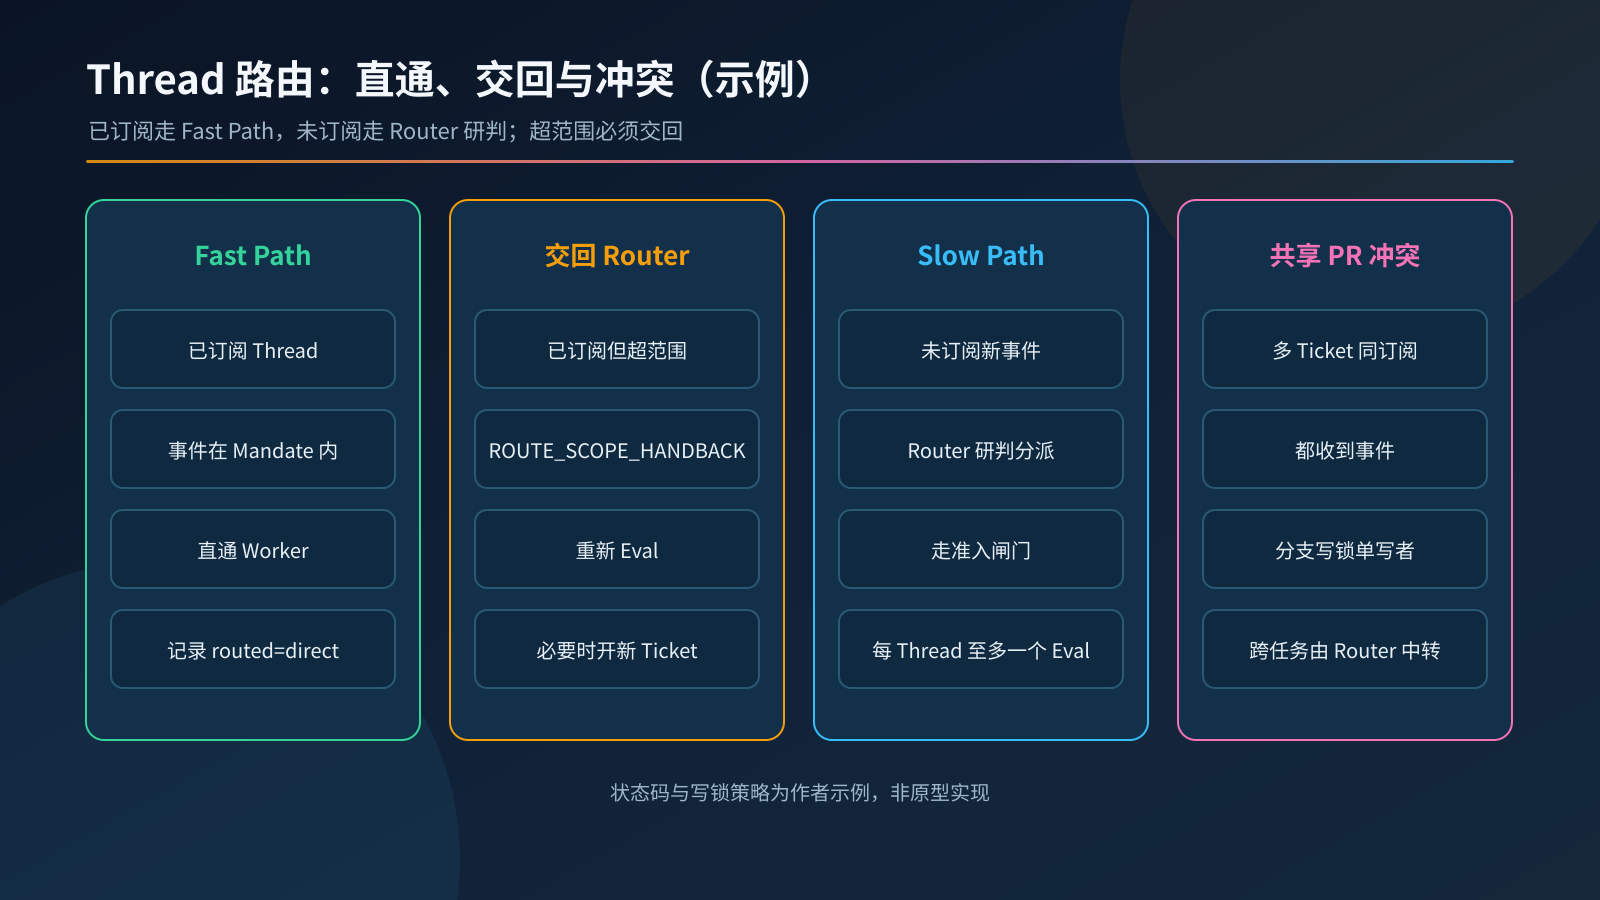
示例路由规则(作者示例):
| 情况 | 路径 | 闸门动作 |
|---|---|---|
| 已订阅 Thread,事件在当前 Mandate 范围内 | Fast Path 直通 Worker | 记录 routed=direct |
| 已订阅 Thread,事件超出范围 | Worker 交回 Router | ROUTE_SCOPE_HANDBACK,新事件重新 Eval |
| 未订阅 Thread | Slow Path,Router 研判 | 走闸门 ① 准入 |
| 多个 Ticket 订阅同一 PR | 都收到事件 | 写锁:同一时刻只允许一个 Worker 推送到该分支 |
| 同一 Thread 上一轮研判未完成 | 新 Trigger 累积 | 批量并入下一轮,保证「每个 Thread 同时最多一个 Eval」 |
最后一行来自原型领域文档的规则:一个 Thread 同一时刻最多只有一个 Eval 在跑。这条看似是性能细节,实际上是一致性保证——它避免了两次研判基于不同快照各自开工。
五、闸门 ④:静默投机——预做可以,打扰要有门槛
文章借用了 CPU 的投机执行(Speculative Execution)思想:Agent 在不确定结果是否被采用时,就根据环境信号在后台先试,有价值就交付,没价值就丢弃。他们在内部用户群里配了一条「静默复现并修复」策略:有人反馈问题时,Agent 后台尝试复现、找修复方案,只有确认问题并找到简单修复时才交付,否则全程保持安静。
这对团队体验很友好,但自建时要补三道约束:
- 交付门槛可量化:什么叫「确认问题」?建议至少要求复现脚本稳定失败、修复后同一脚本通过、相关测试集不回退;
- 算力封顶:投机任务按 Thread、按天设预算上限,超限直接丢弃,不允许「为了不浪费前面的算力再多跑一会」;
- 副作用为零:投机阶段只允许在隔离目录和临时分支里动手,不推送、不评论、不发消息。交付动作本身才走 Channel 回写。
# 作者示例:静默投机策略
speculative:
  enabled_rules: [bug_report_keyword]
  budget:
    per_thread_minutes: 20
    per_day_minutes: 240
  side_effects: none          # 不推送、不评论、不发消息
  deliver_if:
    - repro_script_fails_before: true
    - repro_script_passes_after: true
    - regression_suite: no_new_failures
    - diff_lines_max: 80      # 「简单修复」的示例口径
  else: discard_silently
建议给投机结果单独记一个指标:交付率 = 交付次数 / 投机次数,以及采纳率 = 被人合并或确认的交付 / 交付次数。交付率太高说明门槛太松(在刷屏),采纳率太低说明「有价值」的定义有问题。
六、闸门 ⑤:Watchdog——进程活着不等于任务在推进
文章对 Watchdog 的定位很到位:长期运行的 Agent 系统里,很多异常不是进程崩溃,而是模型陷入无效循环或偏离目标。所以他们在主系统外配置了一个独立的 Watchdog Session,用定时消息驱动,构成外部控制回路;它既处理接口报错、状态恢复失败等基础设施故障,也由模型判断各 Worker 是否有实质进展、方向是否偏离。维护者还能用自然语言问它故障原因,或让它在线修正提示词、调整触发规则。
最后这一点能力很强,也最需要闸门:一个能改触发规则的 Watchdog,本身就是一个能扩大 Agent 权限的入口。
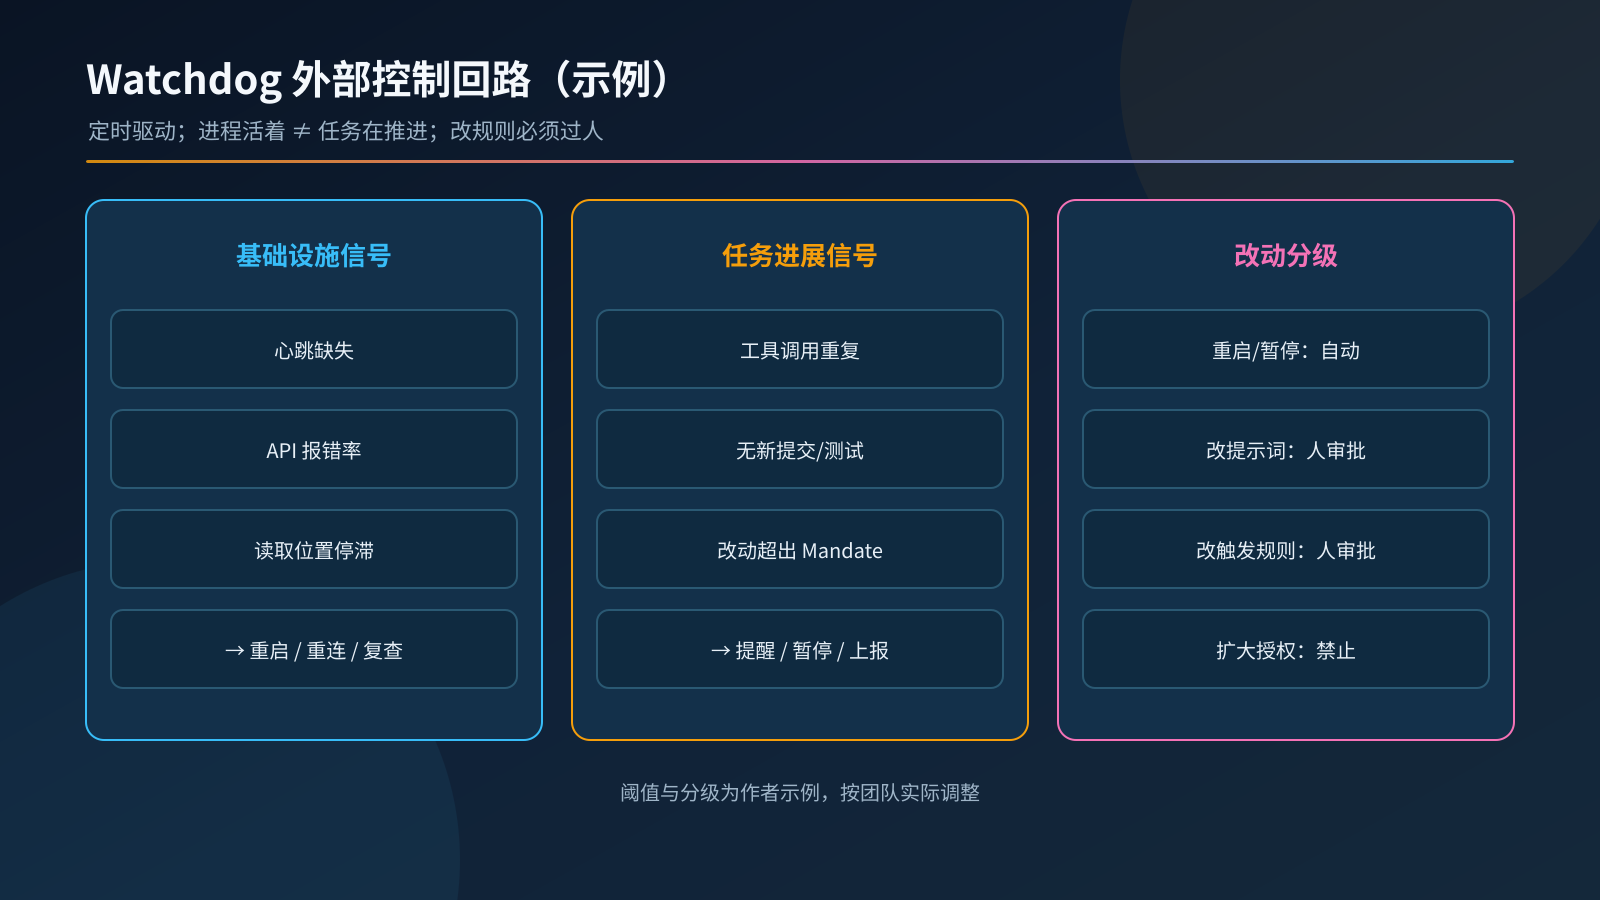
建议把 Watchdog 的检查分成两层:
| 层 | 信号(示例) | 判定(示例阈值) | 动作 |
|---|---|---|---|
| 基础设施 | 进程心跳、API 报错率、事件读取位置是否前进 | 心跳缺失 > 2 个周期;读取位置 30 分钟不动 | 重启 / 重连 / 持续复查直至恢复 |
| 任务进展 | Worker 最近 N 次工具调用是否重复;是否有新提交、新测试结果 | 连续 10 次调用无新产物;同一命令重复 3 次以上 | 提醒 Worker、降级、暂停 Ticket 并上报 Router |
| 方向 | Worker 当前动作与 Mandate 范围是否一致 | 改动文件超出 Mandate 声明路径 | 暂停并要求人确认 |
而 Watchdog 对主系统的修改动作要单独过审批:
# 作者示例:Watchdog 改动分级
WATCHDOG_ACTIONS = {
    "restart_worker":      "auto",          # 可自动执行
    "pause_ticket":        "auto",
    "edit_prompt":         "human_approve", # 需要人确认
    "edit_trigger_rule":   "human_approve", # 触发规则 = 权限边界
    "widen_mandate":       "forbidden",     # Watchdog 永远不能扩大授权
}
七、落地顺序建议
如果你已经有一个「被 @ 才干活」的团队 Agent,想往主动式演进,建议按这个顺序上:
- 先上闸门 ① 的
observe模式:只研判、不执行,统计误触发; - 再把 Mandate 字段补齐(闸门 ②):没有可重验的授权,就不要允许 Ticket 被唤醒;
- 然后拆 Router / Worker 并做 Thread 订阅(闸门 ③),先只开 Fast Path 的范围检查;
- 投机执行最后开(闸门 ④),并且先只开一条规则、给小预算;
- Watchdog 从只读开始(闸门 ⑤):先只报警,跑稳后再给自动重启,改提示词和触发规则永远留人审批。
DeepSeek 在文章结尾也坦言,他们没有提出全新的理论,而是把经典计算机系统思想(序点、事件驱动、投机执行、外部控制回路)用到了 Agent 架构里。对自建团队来说,这恰好是好消息:这些思想都有成熟的工程纪律可以照搬——幂等、不可变授权、单写者、预算封顶、控制面与数据面分离。先把这几条写进闸门,再谈让 Agent 更「主动」。
参考资料
- DeepSeek Harness 团队:《Super-agent 设计探索:迈向更自主的 Agent 系统》(2026-10-31,官方公众号;全文转载见 guobug.github.io)
- GitHub:deepseek-ai/dsh-superagent-prototype(README 与 docs/001-domain.md)
- 第一财经 AI 周报(2026-11-01)相关报道
本文同步发布于 CSDN:https://blog.csdn.net/qq_29737119/article/details/169820098
- fig1-pipeline-gates.png (126 KB)
- fig2-thread-routing.png (125 KB)
- fig3-watchdog-loop.png (115 KB)
