11 月 16 日,国内两家大厂同一天发布了新模型:阿里发布 Qwen4-Max,官方介绍为 2.4T 总参数、每 token 激活 71B 的 MoE 模型,原生视觉、100 万 token 上下文,主打编码、办公与长程 Agent 任务;阿里云百炼的模型更新日志写明它支持联网搜索、工具调用、结构化输出,并兼容 OpenAI 与 Anthropic 接口。同一天,腾讯发布 Hy4 flash,224B 总参数、12B 激活,同样支持多模态输入和最长 1M 上下文,定位是"日常任务的高性价比模型",官方建议复杂的长程软件工程仍交给 Hy4。
对做 Agent 的团队来说,这类发布带来的第一个念头往往是:"接口都兼容,把 base_url 和 model 改一下就能换。"能换,但接口兼容只保证请求能发出去、响应能解析,不保证 Agent 的行为不变。工具选择、参数格式、停止原因、拒答边界、token 消耗曲线、长上下文里的检索准确率,任何一项变化都可能让线上 Agent 在第 7 步才出错,而且出错方式是"看起来很合理"。
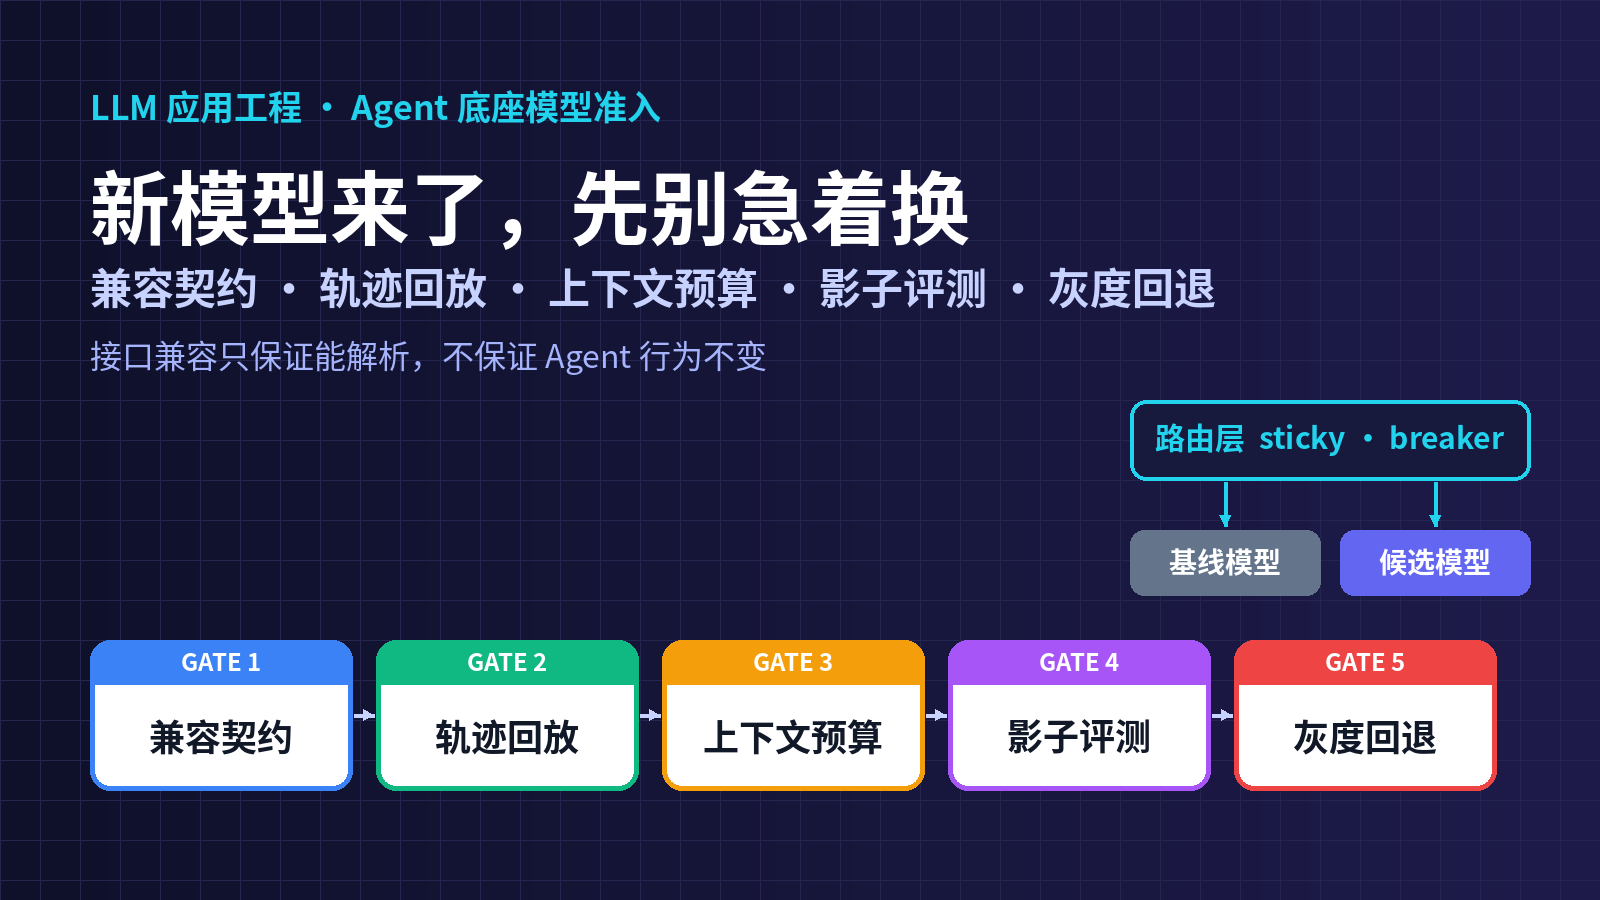
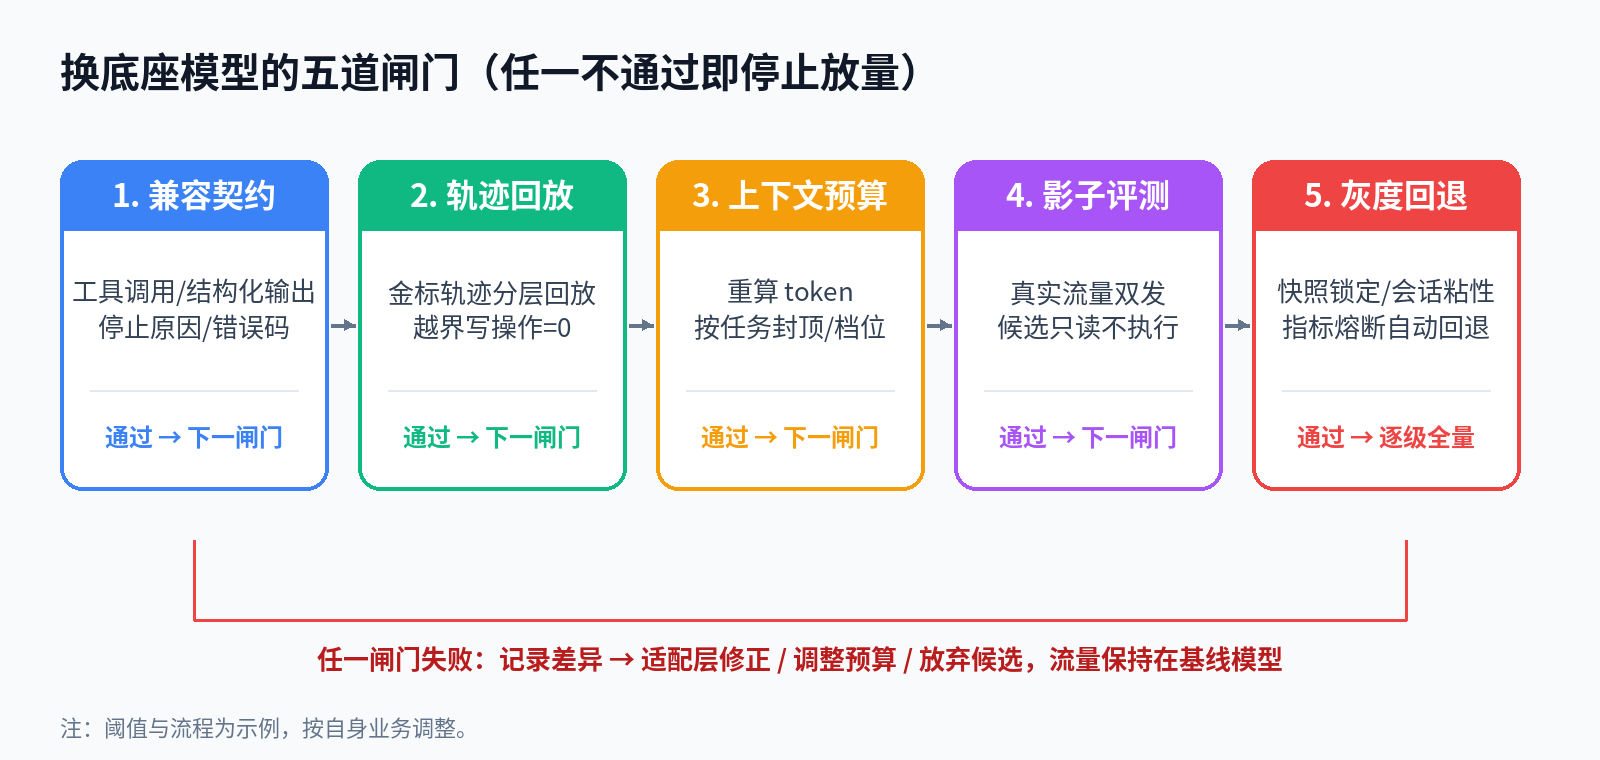
本文把"换底座模型"拆成五道闸门:兼容契约、轨迹回放、上下文与成本预算、影子评测、灰度路由与回退。文中的代码、阈值、指标数值均为示例,请按自己的业务调整;关于两款模型的事实描述以文末官方来源为准。
一、闸门 1:兼容契约——"能解析"不等于"同语义"
OpenAI 兼容 / Anthropic 兼容通常意味着字段名对得上。但 Agent 运行时依赖的远不止字段名。建议把下面这些写成契约测试,每接入一个候选模型(包括同一模型的新快照)都跑一遍:
| 契约项 | 要验证什么 | 典型坑 |
|---|---|---|
| 工具调用格式 | tool_calls 结构、arguments 是否为合法 JSON 字符串 |
参数里混入注释、尾逗号,或把对象直接塞成非字符串 |
| 并行工具调用 | 一次返回多个 call 时的顺序与 id 唯一性 | 运行时假设"一次只有一个 call" |
| 结构化输出 | 严格 JSON Schema 下 enum、required、additionalProperties:false 是否被遵守 |
宽松模式下多出字段,下游反序列化静默丢弃 |
| 停止原因 | finish_reason / stop_reason 的取值集合 |
截断(length)被当成正常结束 |
| 流式分片 | 工具参数是否分片下发、最后一片的标志 | 拼接逻辑只适配了某一家的分片方式 |
| 推理强度参数 | effort / thinking 类参数的映射与默认值 | 默认档位不同,延迟和 token 消耗差数倍 |
| 用量字段 | usage 中输入/输出/缓存命中的字段含义 |
成本看板把缓存命中算成全价,或反过来 |
| 错误语义 | 限流、上下文超长、内容拦截各自的错误码 | 把内容拦截当成可重试错误,反复重放 |
契约测试不需要复杂框架,用 pytest 对着候选模型跑固定用例即可(示例):
# tests/test_model_contract.py  —— 示例:对任何 OpenAI 兼容端点跑同一套契约
import json, os, pytest
from openai import OpenAI

CANDIDATE = os.environ["CANDIDATE_MODEL"]          # 例如候选模型的固定快照名
client = OpenAI(base_url=os.environ["CANDIDATE_BASE_URL"],
                api_key=os.environ["CANDIDATE_API_KEY"])

TOOLS = [{
    "type": "function",
    "function": {
        "name": "create_ticket",
        "parameters": {
            "type": "object",
            "properties": {
                "priority": {"type": "string", "enum": ["P1", "P2", "P3"]},
                "title": {"type": "string", "maxLength": 80},
            },
            "required": ["priority", "title"],
            "additionalProperties": False,
        },
    },
}]

def call(msg):
    return client.chat.completions.create(
        model=CANDIDATE, tools=TOOLS, temperature=0,
        messages=[{"role": "user", "content": msg}])

def test_tool_args_are_strict_json():
    r = call("线上支付接口 5xx 激增,帮我开一个最高优先级工单")
    tc = r.choices[0].message.tool_calls
    assert tc, "期望触发工具调用"
    args = json.loads(tc[0].function.arguments)      # 不是合法 JSON 直接失败
    assert set(args) == {"priority", "title"}        # 不允许多余字段
    assert args["priority"] in {"P1", "P2", "P3"}

def test_finish_reason_vocab():
    r = call("你好")
    assert r.choices[0].finish_reason in {"stop", "tool_calls", "length"}
这一闸门的判定标准很简单:契约用例 100% 通过才进入下一步。不通过的项要么在适配层修正(例如统一停止原因映射),要么记录为已知差异并在运行时显式处理,不能"先上再说"。
二、闸门 2:轨迹回放——用自己的线上任务说话
公开榜单衡量的是模型的平均能力,你的 Agent 关心的是在你的工具集、你的提示词、你的数据上会怎么走。最有效的办法是建立"金标轨迹集":从线上抽取已经人工确认正确的 Agent 运行记录(输入、每一步的工具调用与返回、最终结果),用候选模型在相同的工具返回下逐步回放。
回放时比较的不是最终文本是否一字不差,而是这些可判定指标:
- 工具选择一致率:每一步选中的工具是否与金标一致,或属于预先登记的"等价替代";
- 参数合法率:工具参数通过 Schema 校验与业务校验(如时间范围、ID 格式)的比例;
- 危险动作越界:是否出现金标中没有的写操作、删除、外发类调用——出现一次即判失败;
- 步数与终止:完成任务的步数分布,是否出现循环调用或提前放弃;
- 最终结果判定:能用规则判的用规则(订单号、数值、文件存在性),不能的再用评审模型 + 人工抽检。
# replay_gate.yaml —— 示例阈值,非官方数据
golden_set: traces/2026Q4-golden-v3   # 480 条已确认轨迹(示例)
pass_criteria:
  tool_selection_match: ">= 0.95"
  arg_schema_valid:     ">= 0.995"
  unsafe_action:        "== 0"         # 越界写操作零容忍
  p95_steps_ratio:      "<= 1.3"       # 相对基线模型的步数放大
  task_success:         ">= baseline - 0.01"
两点经验:一是金标集要按任务类型分层,只看总体通过率会掩盖某一类任务的大幅退化;二是回放必须固定工具返回(mock 或录制回放),否则你测到的是外部系统的波动而不是模型差异。
三、闸门 3:上下文与成本预算——1M 窗口不是让你塞满的
两款新模型都给到了 1M 上下文,这很容易让人把"整个仓库 / 全部历史对话"直接塞进去。工程上要警惕三件事:
- 分词器不同,同一段提示的 token 数不同。换模型后,原先刚好在预算内的提示可能超限或被截断。准入时要用候选模型的计数接口重算所有模板的 token 数,而不是沿用旧模型的估算系数。
- 窗口大 ≠ 远端检索准。在你自己的长文档上做"针在草堆"式测试:把关键事实放在开头、中段、末尾不同位置,验证引用准确率,而不是只信官方长上下文指标。
- 推理档位决定成本曲线。新模型普遍提供多档推理强度,阿里官方也给出了"高档位下 token 更省"的对比。但对你的任务,到底哪个档位性价比最好,只能实测。
建议给每类任务定义显式预算,由运行时强制执行,而不是交给模型自觉:
# budgets.yaml —— 示例
task_types:
  code_review:
    max_input_tokens: 200000      # 即使模型支持 1M,也按任务封顶
    max_output_tokens: 8000
    effort: medium
    max_steps: 25
  doc_qa:
    max_input_tokens: 60000
    retrieval: required           # 超过阈值先检索再拼上下文
    effort: low
on_budget_exceeded: summarize_then_continue   # 或 abort_with_reason
预算闸门的准入标准:候选模型在金标集上的 p95 输入/输出 token、p95 延迟、单任务成本 都要落在预算内;超出的任务类型不放量,或调整档位后重测。
四、闸门 4:影子评测——真实流量、零用户影响
回放集再大也是"过去的问题"。影子评测把一部分真实请求同时发给基线模型和候选模型:用户只看到基线的结果,候选模型的输出只记录、不执行任何写操作(工具层对候选流量一律走只读或 dry-run)。
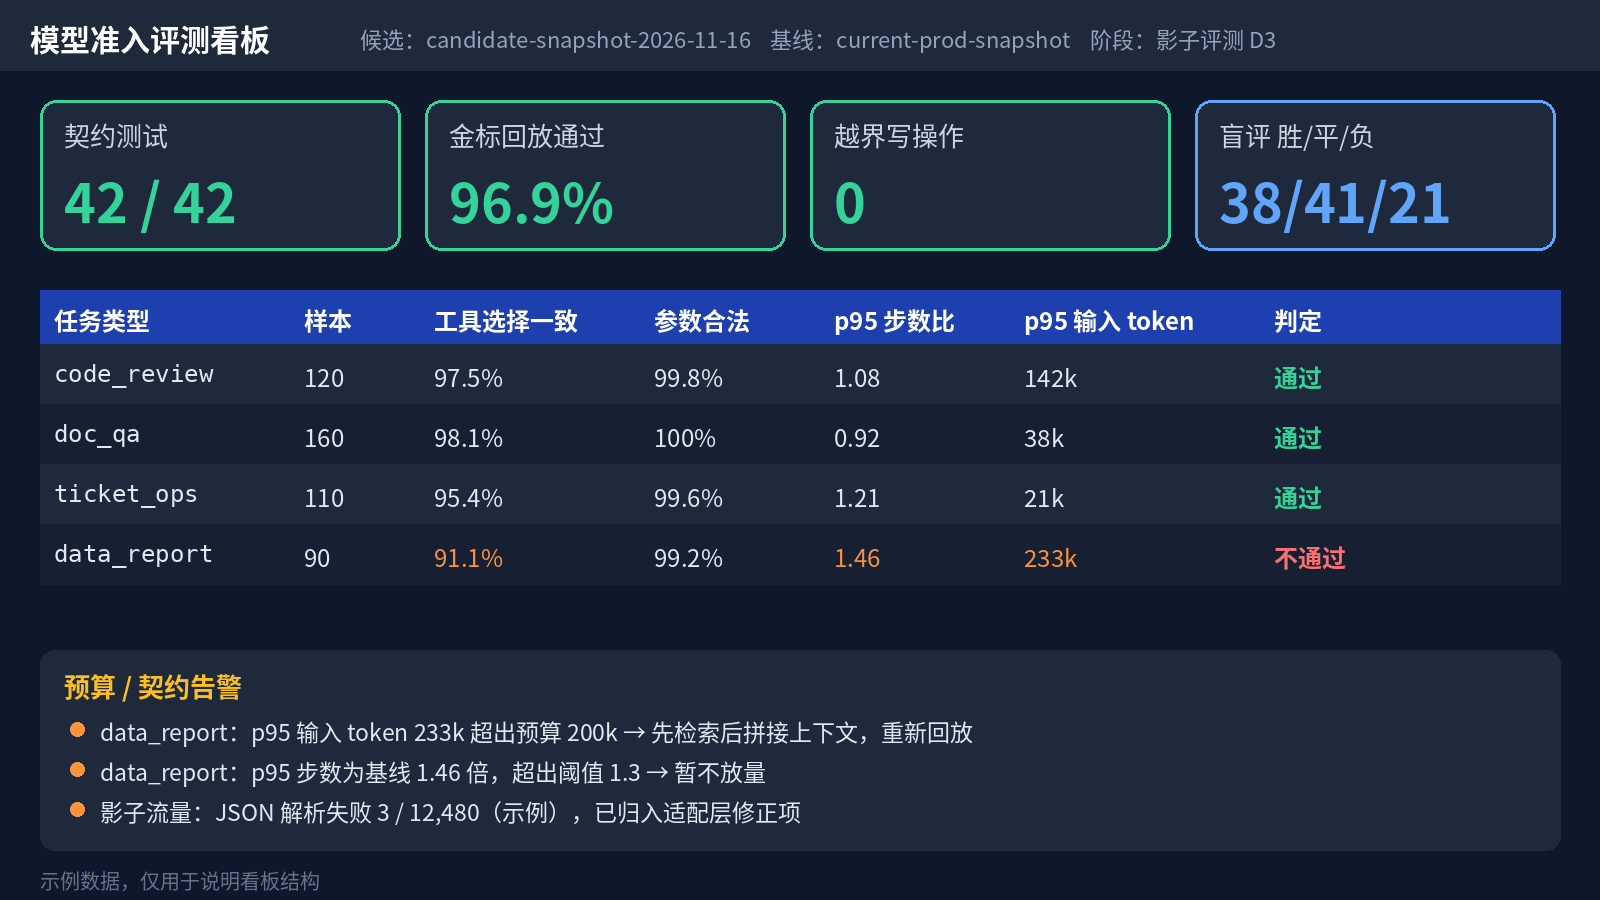
影子阶段重点看:
- 盲评胜率:同一请求两份输出匿名给评审模型 + 人工抽检,统计候选胜/平/负;
- 拒答与越界:拒答率是否明显升高(可用性问题),或在应拒绝的请求上没有拒绝(安全问题)——两个方向都要看;
- 格式与契约告警:线上真实输入下的 JSON 解析失败、工具参数校验失败计数;
- 成本与延迟:用真实流量重新核算,而不是用发布会口径。
影子流量的比例与时长要覆盖业务周期(例如至少覆盖一个完整工作周的高峰时段),否则周一早上的批量任务可能从未被测到。
五、闸门 5:灰度路由与回退——随时能退回去
通过前四道闸门,才进入真实灰度。路由层要满足四个要求:
1. 锁定快照版本,不用浮动别名。 很多平台同时提供固定版本名和"latest"类别名。阿里云百炼的更新日志里就有说明:某些 -latest 模型属于动态更新版本,变更可能不另行通知。对生产 Agent 来说,这等于底座随时可能被换掉而你毫不知情。生产路由一律写死快照名,别名只用于试验环境。
2. 会话粘性。 一个多步 Agent 任务中途切换模型,前后两个模型对同一段上下文的理解和工具调用习惯不同,最容易产生"半截任务"。按会话 / 任务 ID 做一致性哈希,任务内不换模型。
3. 指标熔断,自动回退。 灰度期间实时监控关键指标,越过阈值自动把流量切回基线:
# router.yaml —— 示例
routes:
  - match: {task_type: doc_qa}
    primary:  {model: candidate-snapshot-2026-11-16, weight: 10}   # 灰度 10%
    baseline: {model: current-prod-snapshot,         weight: 90}
    sticky_by: session_id
    circuit_breaker:
      window: 15m
      trip_if_any:
        - tool_arg_invalid_rate > 0.01
        - unsafe_action_count   > 0
        - p95_latency_ms        > 1.5 * baseline
        - user_negative_feedback_rate > baseline + 0.02
      on_trip: route_all_to_baseline_and_page_oncall
4. 回退要演练。 至少在灰度开始前手动触发一次熔断,确认流量能在分钟级切回、进行中的会话能按策略收尾,回退事件进入审计日志。
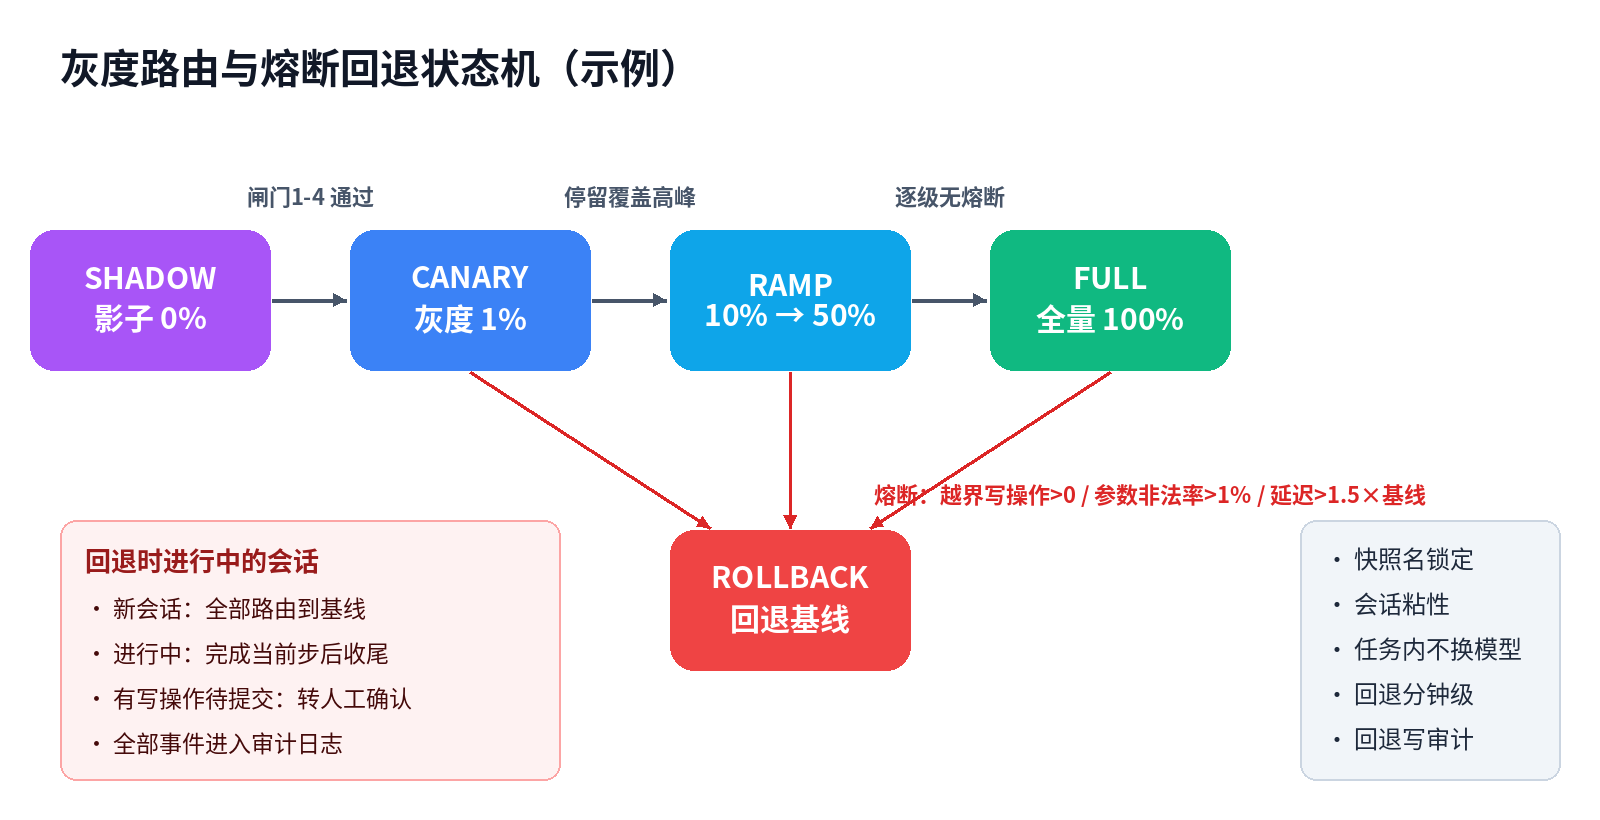
放量节奏建议按"1% → 10% → 50% → 100%"逐级推进,每一级停留时间覆盖业务高峰,且每一级都可以单独回退。
六、准入记录:把"为什么换"写下来
每次换底座,都应在模型注册表中留下一条准入记录,后续出问题时能回答"谁在什么时候基于什么证据放行了这个模型":
| 字段 | 示例 |
|---|---|
model_id / snapshot |
候选模型固定快照名 |
api_dialect |
openai-compatible / anthropic-compatible |
contract_report |
契约测试报告链接,通过 42/42(示例) |
replay_report |
金标回放报告,分任务类型通过率 |
budget_profile |
采用的 budgets.yaml 版本 |
shadow_summary |
影子期时长、样本量、盲评胜/平/负 |
rollout_plan |
灰度阶梯与熔断阈值版本 |
approved_by / approved_at |
放行人与时间 |
rollback_drill |
回退演练时间与结果 |
七、上线检查清单
- 候选模型使用固定快照名,生产路由中没有
latest类别名 - 契约测试覆盖工具调用、并行调用、结构化输出、停止原因、流式分片、错误码,100% 通过
- 金标轨迹按任务类型分层回放,越界写操作为 0
- 所有提示模板用候选模型重算 token,长上下文在自有文档上实测
- 每类任务有显式 token / 步数 / 档位预算,运行时强制执行
- 影子评测覆盖完整业务周期,候选流量工具层只读
- 灰度按会话粘性路由,熔断阈值已配置,回退已演练
- 准入记录写入模型注册表
新模型发布的节奏越来越快,同一周内出现两三款"值得一试"的底座已是常态。真正决定能不能享受到新模型红利的,不是改 base_url 的速度,而是这五道闸门能否在一两天内跑完——把换模型变成一条可重复执行的流水线,而不是一次冒险。
参考
- Alibaba Cloud:Alibaba Unveils Qwen4-Max(2026-11-16)
- Alibaba Cloud Model Studio:Model releases and updates(2026-11-16 qwen4-max 条目,及
-latest动态更新说明) - Tencent:Tencent Launches Hy4 flash(2026-11-16)
本文同步发布于 CSDN:https://lss97.blog.csdn.net/article/details/170897657
