上一篇(Qwen4-Max、Hy4 flash 同日上线之后:自建 Agent 换底座模型先过兼容契约等闸门)讨论的是"大模型换底座"。这一篇换一个方向:Agent 里那些不需要写文章、只需要做判断的环节,该不该交给专门的决策模型?
11 月 16–17 日,Liquid AI 发布了 d1.2 与 d1.2-ultra 两个托管决策模型(decision model)。按官方博客和文档的描述,这类模型不生成自由文本,而是对"带类型的问题"直接返回校准过的概率:
- 是/否题(Noul)返回"是"的概率;单选(Choice)、打分(Score)返回最可能选项、置信度和完整分布;
- 本次新增五类任务:从输入中读取值(文本/数字/日期,读不到时返回 "not found" 而不是猜)、找出某类所有片段(spans,如个人信息)、图片中框选对象(box/boxes)、带区间的数量估计(number with range)、多选(choice with
multiple); - 新增音频输入,可以问"来电者说的是哪种语言""背景里有没有警笛声";
- 一次请求最多 128 个问题,在一次前向中全部作答,只按输入计费、输出不计费;旧的
d1、d1.1、d1-ultra已标记弃用,不支持音频和新题型。
对 Agent 开发者来说,这条新闻真正值得关注的不是榜单分数,而是一种工程分工的变化:过去我们让通用大模型"写一段 JSON 再解析"来做分类、路由、抽取,现在可以把这些判断点交给一个只回答类型化问题、并且给出概率的组件。分工变了,闸门也要跟着变:概率要能被阈值化,"没找到"要能被分流,请求要有预算,模型升级要能被回放。
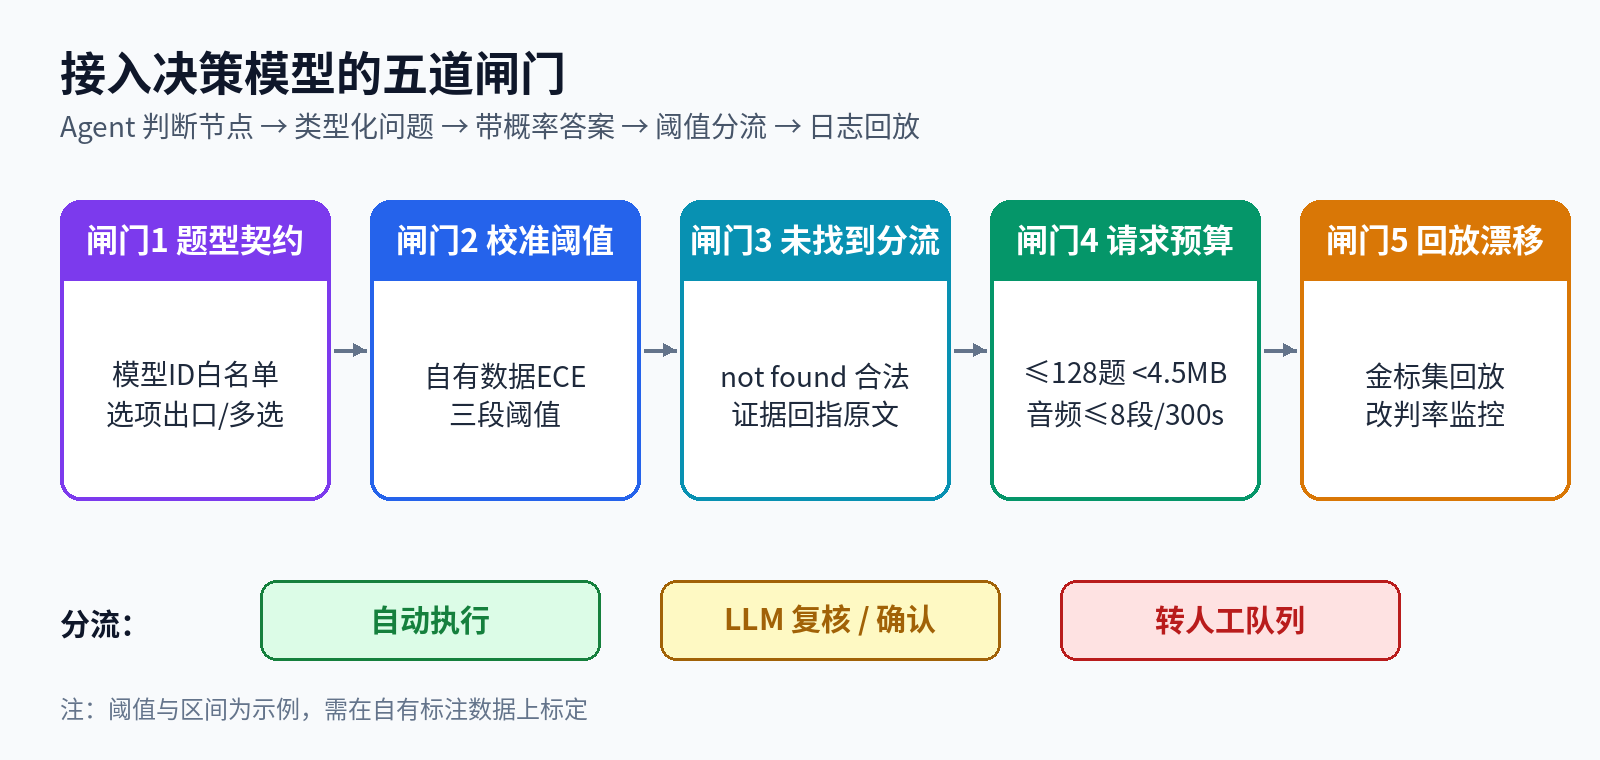
下面把接入决策模型拆成五道闸门。文中的阈值、比例、字段名均为示例,接口字段请以 Liquid 官方文档为准。
一、先盘点:Agent 里哪些节点是"判断",哪些是"生成"
决策模型不是用来替代主模型的。先把 Agent 流程里的节点分成两类:
| 节点 | 典型例子 | 适合的组件 |
|---|---|---|
| 生成 | 写回复、写代码、写总结、多步规划 | 通用 LLM |
| 判断:是/否 | 是否需要人工、是否涉及退款、是否含敏感信息 | 决策模型 Noul |
| 判断:路由 | 交给哪个子 Agent / 哪个工具 / 哪个部门 | 决策模型 Choice |
| 判断:分级 | 紧急度 1–5、风险等级 | 决策模型 Score |
| 抽取 | 发票金额、到期日、订单号 | 决策模型 Text / Number / Date |
| 脱敏定位 | 找出所有姓名、电话、证件号片段 | 决策模型 Spans |
| 多标签 | 一条工单同时涉及"物流"和"账单" | 决策模型 Choice + multiple |
经验上,判断节点的错误往往比生成节点更隐蔽:生成写错了用户看得到,路由错了只会"默默地进了错误的队列"。所以判断节点更需要概率和阈值,而不是一句看上去很自信的自然语言。
二、闸门 1:题型契约闸门——每个判断点先写成"类型化问题"
把判断点交给决策模型之前,先把它写成一份版本化的问题契约,而不是散落在代码里的字符串。
# decision_contracts/support_router.v3.yaml(示例)
contract_id: support_router
version: 3
model: d1.2            # 固定模型 ID,禁止使用已弃用的 d1 / d1.1 / d1-ultra
fallback_model: null   # 不允许静默降级
questions:
  department:
    type: choice
    instructions: "Which team should handle this?"
    criteria:
      billing: "Payments, invoices, refunds"
      technical: "Bugs, outages, errors"
      sales: "Pricing, plans, upgrades"
  is_urgent:
    type: noul
    instructions: "Does this message convey urgency?"
  topics:
    type: choice
    multiple: true
    instructions: "Which topics does the message raise?"
    criteria: {delivery: "Shipping, delivery", billing: "Charges", account: "Login, account"}
  order_no:
    type: text
    instructions: "What is the order number?"
契约闸门检查的内容:
- 模型 ID 白名单:只允许
d1.2/d1.2-ultra;出现弃用 ID 直接拒绝上线。官方说明旧模型保留原有题型但没有音频和新题型,混用会导致同一契约在不同环境行为不一致。 - 选项完备性:Choice 的
criteria必须覆盖"其他/无法判断"的出口,或者在下游明确"低置信度 = 无法判断"。没有出口的单选,模型只能在已有选项里挑一个。 - 单选还是多选:一条消息可能同时属于多个类别时,用
multiple,不要用单选再"取前两名"。 - 数量上限:一个请求不超过 128 个问题;每个问题(连同共享的 state、图片、音频)不超过 65,536 token、250,000 字节文本——中文、日文、韩文文本可能先撞到字节上限。
- 契约变更走评审:改 instructions、改选项文字,都等同于改模型输入,必须升版本号并触发回放(见闸门 5)。
三、闸门 2:校准阈值闸门——概率要先在自己的数据上"验过秤"
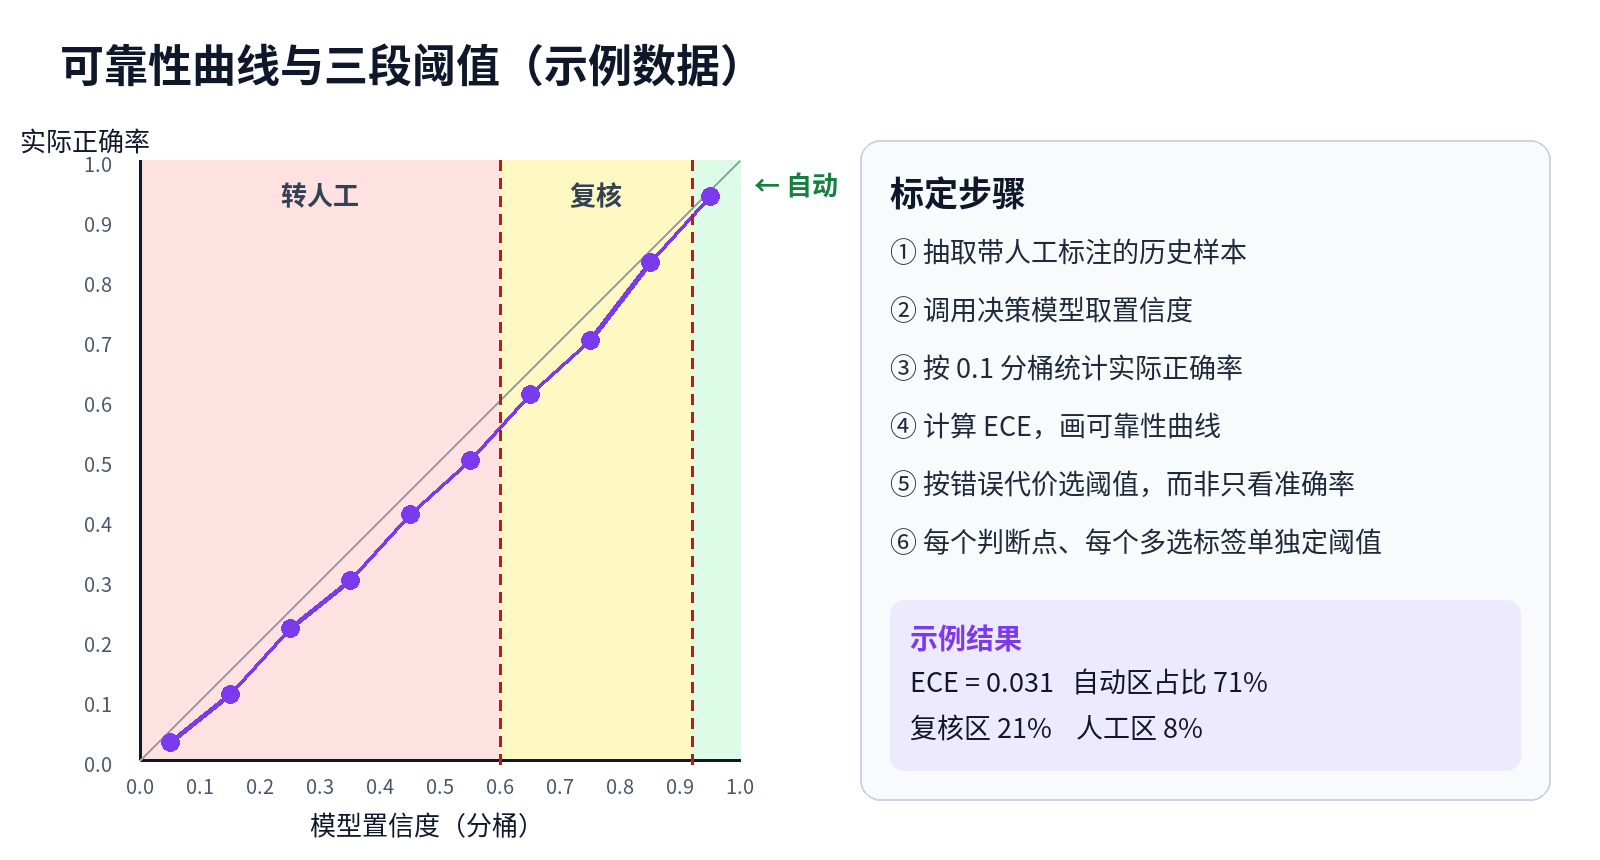
决策模型的价值在于概率可以直接拿来设阈值。Liquid 在博客中给出了校准误差对比,并解释"模型说 80%,就应当大约 80% 的时候是对的"。但厂商的校准数字来自它的评测集,不代表你的业务数据。上线前要做一次自己的校准检查:
- 从历史数据中抽取带人工标注的样本(示例:每个判断点 ≥ 500 条,覆盖长尾类别);
- 调用决策模型拿到置信度,按 0.1 分桶,统计每个桶的实际正确率;
- 计算期望校准误差(ECE),并画出可靠性曲线;
- 根据错误代价而不是"准确率最大"来定阈值。
import numpy as np

def ece(conf, correct, bins=10):
    """期望校准误差:各桶 |平均置信度 - 实际正确率| 的加权平均"""
    conf, correct = np.asarray(conf), np.asarray(correct, dtype=float)
    edges = np.linspace(0, 1, bins + 1)
    total = 0.0
    for lo, hi in zip(edges[:-1], edges[1:]):
        m = (conf > lo) & (conf <= hi)
        if m.any():
            total += m.mean() * abs(conf[m].mean() - correct[m].mean())
    return total

def pick_threshold(conf, correct, cost_wrong_auto=20.0, cost_human=1.0):
    """在候选阈值中选总代价最小者:高于阈值自动执行,低于阈值转人工(示例代价)"""
    conf, correct = np.asarray(conf), np.asarray(correct, dtype=bool)
    best = None
    for t in np.arange(0.50, 0.99, 0.01):
        auto = conf >= t
        cost = cost_wrong_auto * (auto & ~correct).sum() + cost_human * (~auto).sum()
        if best is None or cost < best[1]:
            best = (round(float(t), 2), float(cost))
    return best
阈值不要只设一条。建议对每个判断点设三段:
| 区间(示例) | 动作 | 说明 |
|---|---|---|
| p ≥ 0.92 | 自动执行 | 直接路由或直接通过 |
| 0.60 ≤ p < 0.92 | 降级执行 | 交给通用 LLM 复核,或加一个确认步骤 |
| p < 0.60 | 转人工 | 写入人工队列,附上完整分布 |
两个容易忽略的点:
- 不同判断点阈值不同。"是否涉及退款"判错的代价远高于"是否属于物流话题",不要全局共用一个 0.8。
- 多选题逐项设阈值。多选返回每个选项各自的概率,某个标签的阈值应基于这个标签自己的校准结果。
四、闸门 3:未找到与证据闸门——"not found" 是合法答案,不是异常
d1.2 的抽取类题型在目标不存在时会返回 "not found"(官方示例中 Python 读到的值为 None),同时会返回所读取值对应的原文字符。这对 Agent 的意义是:抽取环节终于有了"我不知道"的正式出口。下游必须把它当作一种业务状态来处理,而不是用默认值填平。
NOT_FOUND = object()

def gate_extraction(name, answer, state_text, required=True):
    """抽取答案闸门(示例)。answer 的字段名请按官方文档实际返回调整。"""
    value = answer.get(name_to_field(name))          # 如 'number' / 'text' / 'date'
    if value is None:
        # 1) 未找到:必填字段转人工或回问用户,禁止填默认值
        return ("ASK_USER" if required else "SKIP", NOT_FOUND)
    evidence = answer.get("evidence_text")           # 示例字段:模型读取的原文片段
    if evidence and evidence not in state_text:
        # 2) 证据不在原文中:视为异常,记录并转人工
        return ("HUMAN_REVIEW", value)
    return ("ACCEPT", value)

def name_to_field(name):
    return {"total": "number", "due": "date"}.get(name, "text")
证据闸门的检查清单:
- 证据回指:抽取值必须能回指到 state 中的一段原文;对数字和日期,再做一次本地解析校验(例如"1 234,50"按欧洲格式解析为 1234.5,日期格式要和上下文中的说明一致)。
- 必填与可选分开:必填字段 "not found" → 回问用户或转人工;可选字段 "not found" → 正常跳过。
- 禁止"补全式"回退:不要在决策模型返回 not found 后,立刻让通用 LLM "再猜一次"并直接采用——这等于把好不容易得到的弃权信号又抹掉了。若确需 LLM 复核,其结果也只能进入人工确认。
- Spans 用于脱敏时反过来用:脱敏要的是召回率。官方内部测试中个人信息片段的召回率并非 100%,因此 spans 结果应与规则(正则、字典)取并集,而不是取代规则。
五、闸门 4:请求预算闸门——尺寸、时长和问题数先在本地算清楚
决策模型按输入计费、一次请求可以挂很多问题,这会诱导人"把所有问题塞进一个请求"。上线前在客户端做预算检查:
| 限制(据官方文档) | 本地检查 |
|---|---|
| 单请求问题数 ≤ 128 | 超出则按契约拆分为多个请求 |
| 单请求 JSON 体 < 4.5 MB(含 Base64 图片/音频) | 按编码后大小计算,而不是原始文件大小 |
| 每请求音频 ≤ 8 段、总时长 ≤ 300 秒 | 超出则切片或先做语音活动检测 |
| 未压缩 16 kHz 16-bit 单声道 WAV 约 100 秒就会触到 4.5 MB | 长录音优先 MP3 / FLAC / OGG |
| 校验失败返回 422 | 422 视为契约缺陷,阻断发布,不做盲目重试 |
import base64, json

MAX_BODY = 4.5 * 1024 * 1024
MAX_Q, MAX_CLIPS, MAX_AUDIO_SEC = 128, 8, 300

def budget_check(payload: dict, audio_secs: list[float]) -> list[str]:
    errs = []
    if len(payload.get("questions", {})) > MAX_Q:
        errs.append("questions>128")
    if len(audio_secs) > MAX_CLIPS:
        errs.append("audio clips>8")
    if sum(audio_secs) > MAX_AUDIO_SEC:
        errs.append("audio total>300s")
    size = len(json.dumps(payload, ensure_ascii=False).encode("utf-8"))
    if size >= MAX_BODY * 0.95:                     # 留 5% 余量(示例)
        errs.append(f"body {size/1024/1024:.2f}MB too close to limit")
    return errs
还有一项是成本归因:同一个 state 只计一次,每个问题追加自己的 instructions、选项和答案槽。把"每个判断点的问题 token"单独记账,否则某个契约把选项从 5 个改到 50 个,账单变化很难定位到人。
六、闸门 5:回放与漂移闸门——模型升级、契约改版都要先过金标集
决策模型同样会升级(这次 d1.1 → d1.2 就是例子),契约文本也会被人改。每一次变化都应走回放:
- 决策日志:每次调用记录
contract_id@version、模型 ID、state 哈希、每题的答案与完整分布、最终路由动作、是否被人工改判; - 金标集回放:维护一份带人工标注的固定样本集(示例:每个契约 300–1000 条),变更前后各跑一遍,对比准确率、ECE、各区间占比;
- 放行条件(示例):准确率不下降超过 1 个百分点、ECE 不上升超过 1 个点、"自动执行"区间的错误数不增加;
- 线上漂移监控:按天统计置信度分布和人工改判率。置信度整体下移、人工改判率上升,通常意味着输入分布变了(新产品线、新话术),要先补样本再调阈值。
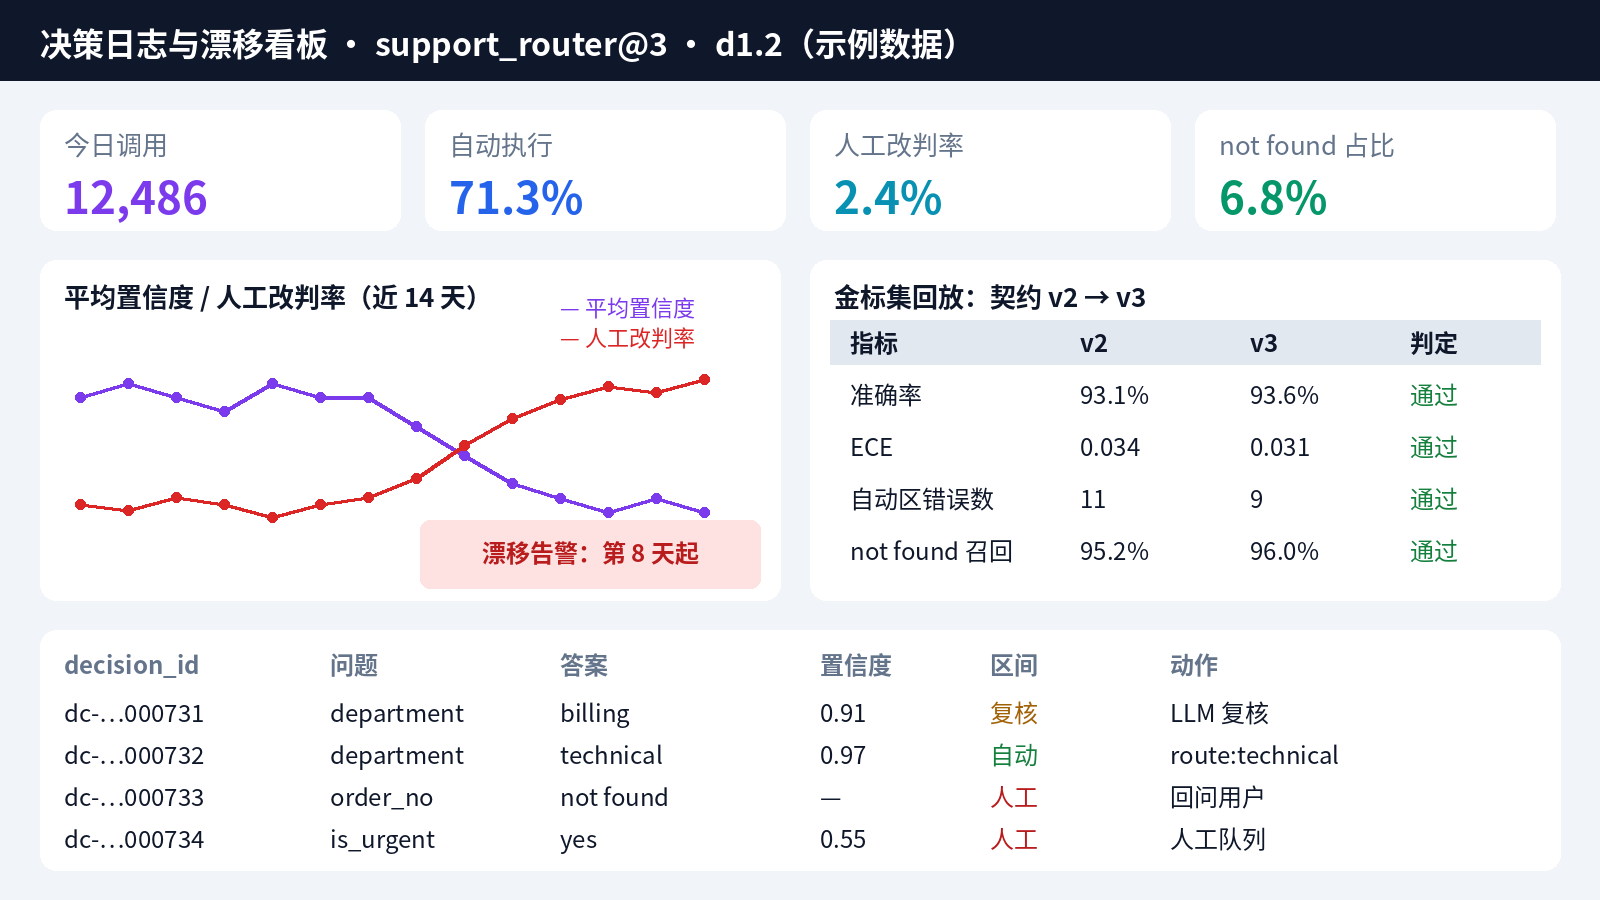
决策日志建议的最小字段:
| 字段 | 说明 | 示例 |
|---|---|---|
decision_id |
调用唯一 ID | dc-20261118-000731 |
contract |
契约及版本 | support_router@3 |
model |
模型 ID | d1.2 |
state_sha256 |
输入哈希(原文另存,按隐私策略脱敏) | 9f3a… |
answers |
每题答案 + 分布 | {"department": {"billing": 0.91, ...}} |
zone |
落入的阈值区间 | auto / review / human |
action |
最终动作 | route:billing |
override |
人工是否改判及改判结果 | technical |
latency_ms |
耗时 | 142 |
七、把五道闸门串起来
下面是一个最小的调用骨架,演示"契约 → 预算 → 调用 → 阈值 → 日志"的顺序。端点与请求体结构参考官方文档示例,返回字段名请以文档为准。
import os, time, uuid, hashlib, requests

API = "https://api.liquid.ai/decisions/v1/systemone"
THRESH = {"department": (0.92, 0.60), "is_urgent": (0.85, 0.50)}   # 示例阈值

def decide(contract, state_text, log):
    payload = {"model": contract["model"], "state": state_text,
               "questions": contract["questions"]}
    errs = budget_check(payload, audio_secs=[])
    if errs:
        raise ValueError(f"budget gate: {errs}")
    t0 = time.time()
    r = requests.post(API, json=payload, timeout=10,
                      headers={"Authorization": f"Bearer {os.environ['LIQUID_API_KEY']}"})
    if r.status_code == 422:
        raise RuntimeError("contract gate: request rejected by validation")
    r.raise_for_status()
    answers = r.json()["answers"]

    dept = answers["department"]
    hi, lo = THRESH["department"]
    conf = dept.get("confidence", 0.0)
    zone = "auto" if conf >= hi else ("review" if conf >= lo else "human")

    log.write({
        "decision_id": f"dc-{uuid.uuid4().hex[:12]}",
        "contract": f'{contract["contract_id"]}@{contract["version"]}',
        "model": contract["model"],
        "state_sha256": hashlib.sha256(state_text.encode()).hexdigest(),
        "answers": answers, "zone": zone,
        "latency_ms": int((time.time() - t0) * 1000),
    })
    return zone, dept.get("choice")
八、上线检查清单
- Agent 流程中所有"判断类"节点已盘点,并标注由谁负责(通用 LLM / 决策模型 / 规则)
- 每个判断点有版本化契约,模型 ID 在白名单内,无弃用 ID
- 单选题有"无法判断"出口或低置信度出口;多标签场景使用
multiple - 已在自有标注数据上计算 ECE、画可靠性曲线,按错误代价定三段阈值
- 抽取题 "not found" 有明确业务处理,禁止默认值填充;抽取值可回指原文
- 脱敏场景 spans 与规则取并集
- 客户端预算检查:问题数、编码后请求体大小、音频段数与时长
- 422 视为契约缺陷阻断发布
- 决策日志字段齐全,人工改判可回写
- 模型升级与契约改版必须通过金标集回放;线上监控置信度分布与改判率
结语
通用大模型让 Agent 能"说",决策模型让 Agent 的每一次"选"都带上可以被检查的概率。但概率本身不会自动带来可靠性:契约要固定、阈值要按自己的数据定、"没找到"要被尊重、请求要有预算、每次变更都要回放。把这五道闸门做进流水线,换哪家的决策模型、换几次版本,Agent 的判断质量都有据可查。
参考资料
- Liquid AI 博客:d1.2: State-of-the-Art Omnimodal Decision Models — https://www.liquid.ai/blog/d1-2
- Liquid AI 文档:Decisions — https://docs.liquid.ai/api/guides/decisions
- Liquid AI 文档:d1.2 — https://docs.liquid.ai/lfm/models/d1
- MarkTechPost:Liquid AI Releases d1.2 and d1.2-ultra(2026-11-17)— https://www.marktechpost.com/2026/11/17/liquid-ai-d1-2-omnimodal-decision-models/
本文同步发布于 CSDN:https://lss97.blog.csdn.net/article/details/170966861
