来源:CSDN 公子(qq_29737119)
搜索智能体这两年几乎被闭源产品垄断。9 月中旬,AllSpark Research 把 Iris-mini (约 35B,激活 3B)和 Iris-pro (约 397B,激活 17B)权重放到 Hugging Face,Apache 2.0,配套论文讲清了数据构造与 SFT–RL climbing 训练流程。更值得写进工程笔记的是:在同样工具集和上下文上限下,**开不开上下文管理,分差可以大过「换一个更大的开源
五、怎么上手(工程向速查)
权重 Apache 2.0,可用 sglang 拉起(以官方模型卡为准),例如 Iris-mini:
python -m sglang.launch_server \
--model-path AllSpark-Research/Iris-mini \
--served-model-name Iris-mini \
--port 21234 --tp-size 4 \
--context-length 262144 \
--reasoning-parser qwen3 \
--tool-call-parser qwen3_coder
再用官方 Iris-Harness 复现评测(示例):
bash scripts/run_eval.sh \
--base-url http://127.0.0.1:21234/v1 \
--llm-config iris-mini \
--benchmarks "browsecomp:0:1" \
--context-discard-threshold 131072
单机友好规格是 Iris-mini(激活约 3B):先复现 discard-all,再决定要不要上 pro。
六、写给国内开发者的三点判断
• 开源搜索 Agent 终于有可对标的同档标杆——不只是「能跑 Demo」,而是把数据、训练交替、评测 harness 一起讲清楚。
• 产品侧优先投上下文与轨迹压缩,别默认「换更大基座」是第一杠杆。
• 合规与溯源仍要自己补:公开报道对 AllSpark Research 机构归属说法不一,商用前建议核对许可证、数据来源与安全策略;搜索 Agent 会访问外网,权限与审计不能省。
参考链接
• 论文:https://arxiv.org/abs/2609.04304 (Iris: Climbing to the Search Frontier)
• HF:https://huggingface.co/AllSpark-Research/Iris-mini 、https://huggingface.co/AllSpark-Research/Iris-pro
• 中文解读参考:https://news.cocoloop.cn/2026/09/iris-open-search-agent/
有个反直觉的点:BrowseComp-ZH 上,mini 84.8、pro 85.1,只差 0.3;英文 BrowseComp 却差 6.4。中文多跳题上,单纯堆规模换来的红利很小——更要把力气花在轨迹与上下文策略上。
三、真正拉开分差的:discard-all 与 retry
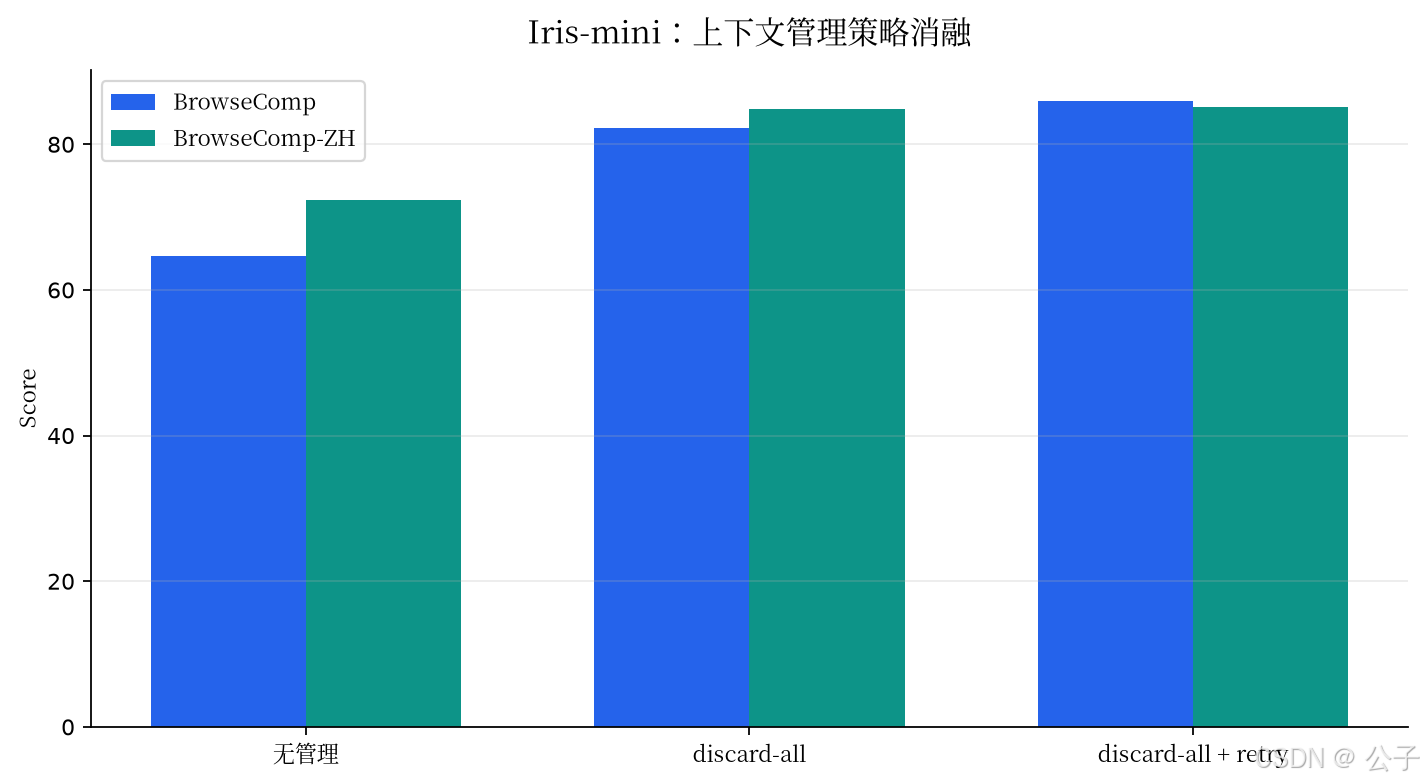
团队在固定工具集、上下文上限和判分器的前提下,对比了三种推理时策略:
• 无管理:工具历史一路堆
• discard-all:prompt 超阈值后清空工具历史,从原问题重新开局
• retry:本轮没给出可解析答案时,带着「已排除线索」的短摘要重启
Iris-mini 的 BrowseComp:无管理 64.7 → discard-all 82.2 → 再叠加 retry 到 85.9。小模型涨分更猛,论文解释是:同样任务它步数更多,更容易撞上下文上限。
对做 Agent / Deep Research 的同学,这句话几乎可以直接贴到设计文档:
在搜索智能体上,管住搜索历史,往往比再堆一档参数更划算。
四、训练数据怎么造:从超链接「倒推」多跳题
人工写跨三四个网页的多跳题又贵又容易被字面匹配绕过。Iris 的做法是反过来:
• 从网页语料超链接挑种子页,蒸出实体图
• 在图上编多跳链条
• 把题面改写,保证线索不能靠字符串直接命中答案页
• 只保留「闭卷做不出、给证据能做出」的题
训练流程叫 SFT–RL climbing:监督微调与强化学习交替;RL 段对着 真实在线搜索 优化(不是离线快照),奖励模型与观察摘要模块跑在训练集群内。工程成本不低,但更接近真实产品形态。
对手」**。
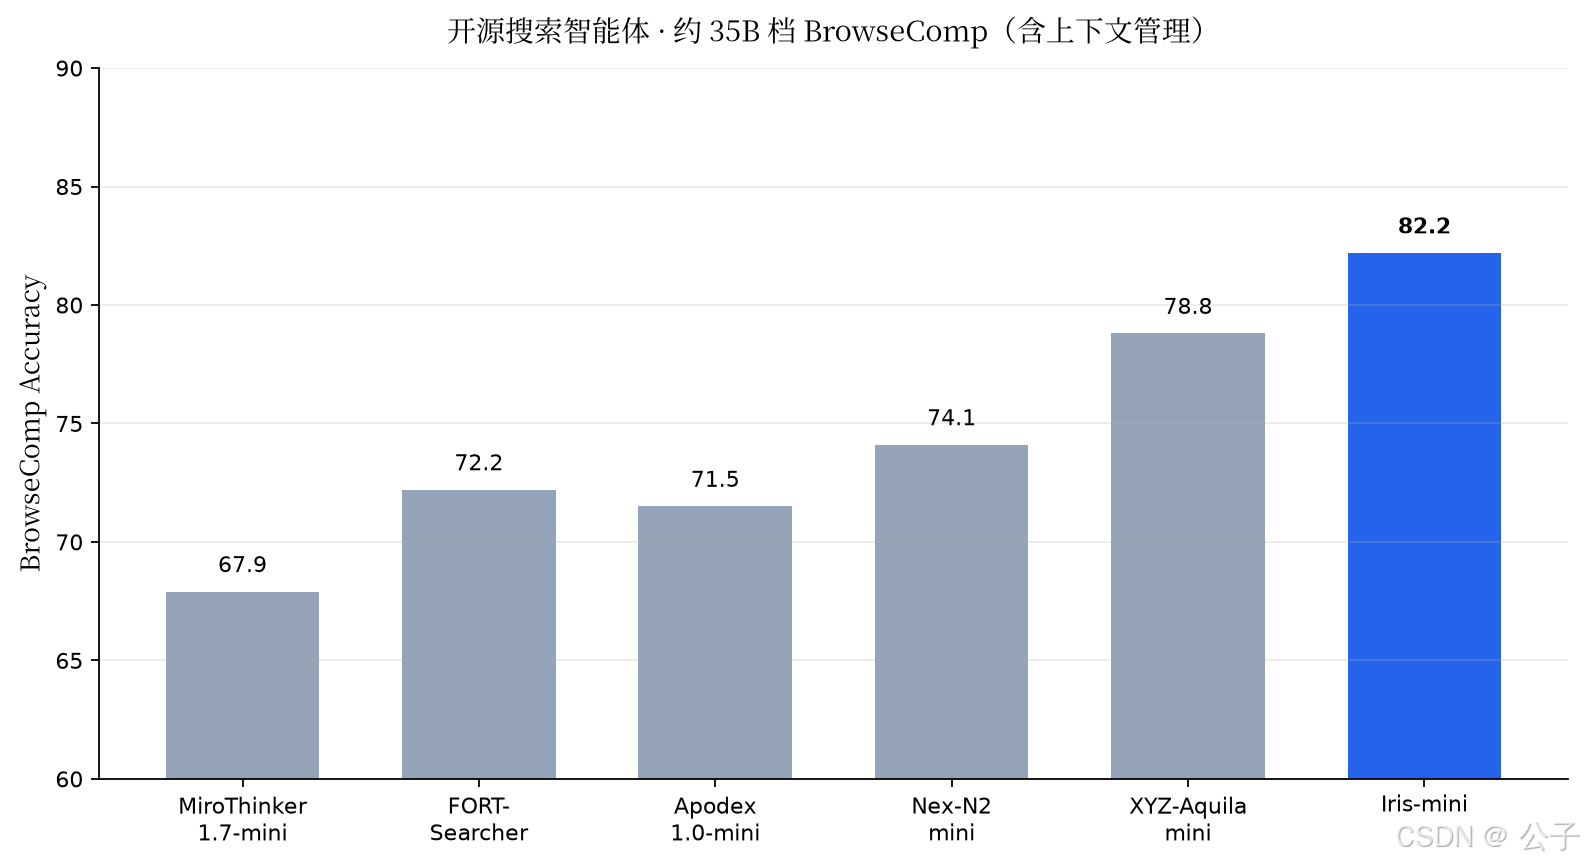
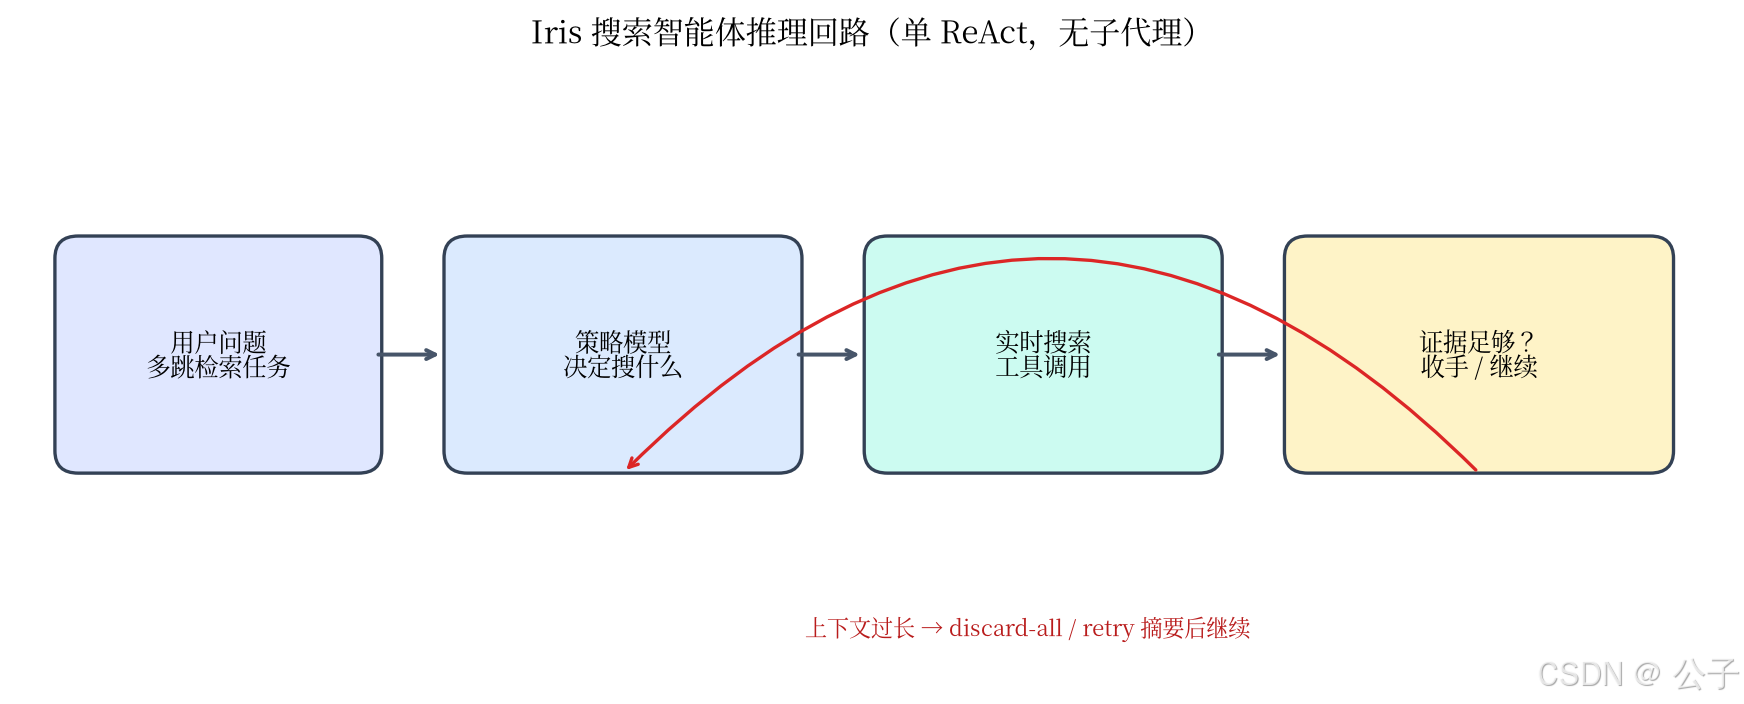 ## 一、为什么「会搜」比「会聊」更难普通对话模型答已有知识;搜索智能体要自己决定:• 这一跳该搜什么关键词• 看完结果要不要继续• 什么时候证据够了可以收手过去两年这条能力线基本被闭源产品占着:模型 + 调度框架两头一起调。开源侧往往只放权重、不放「怎么管越滚越长的工具历史」——而多跳搜索里,工具调用轨迹会很快把 256K 窗口填满。Iris 的定位很明确:在 Qwen 系 MoE 上做后训练,专门优化这条「搜—读—再搜」回路,并且把推理时的上下文管理当成一等公民来评测。—## 二、两档规格与四项基准| 模型 | 基座(公开口径) | 总参 / 激活 | 上下文 ||------|------------------|-------------|--------|| Iris-mini | Qwen3.6-35B-A3B | ~35B / ~3B | 256K || Iris-pro | Qwen3.5-397B-A17B | ~397B / ~17B | 256K |论文报告的四项基准(开启上下文管理后的 headline 成绩):| 模型 | BrowseComp | BrowseComp-ZH | DeepSearchQA (F1) | HLE ||------|------------|---------------|-------------------|-----|| Iris-mini | 82.2 | 84.8 | 86.9 | 52.3 || Iris-pro | 88.6 | 85.1 | 92.9 | 56.4 |同一参数档内,两者整体是开源搜索智能体里最强之一;Iris-mini 在 BrowseComp 上比同档 XYZ-Aquila-mini(78.8)高出约 3.4 分。
- img_092.png (48 KB)
- img_093.png (96 KB)
- img_094.png (75 KB)