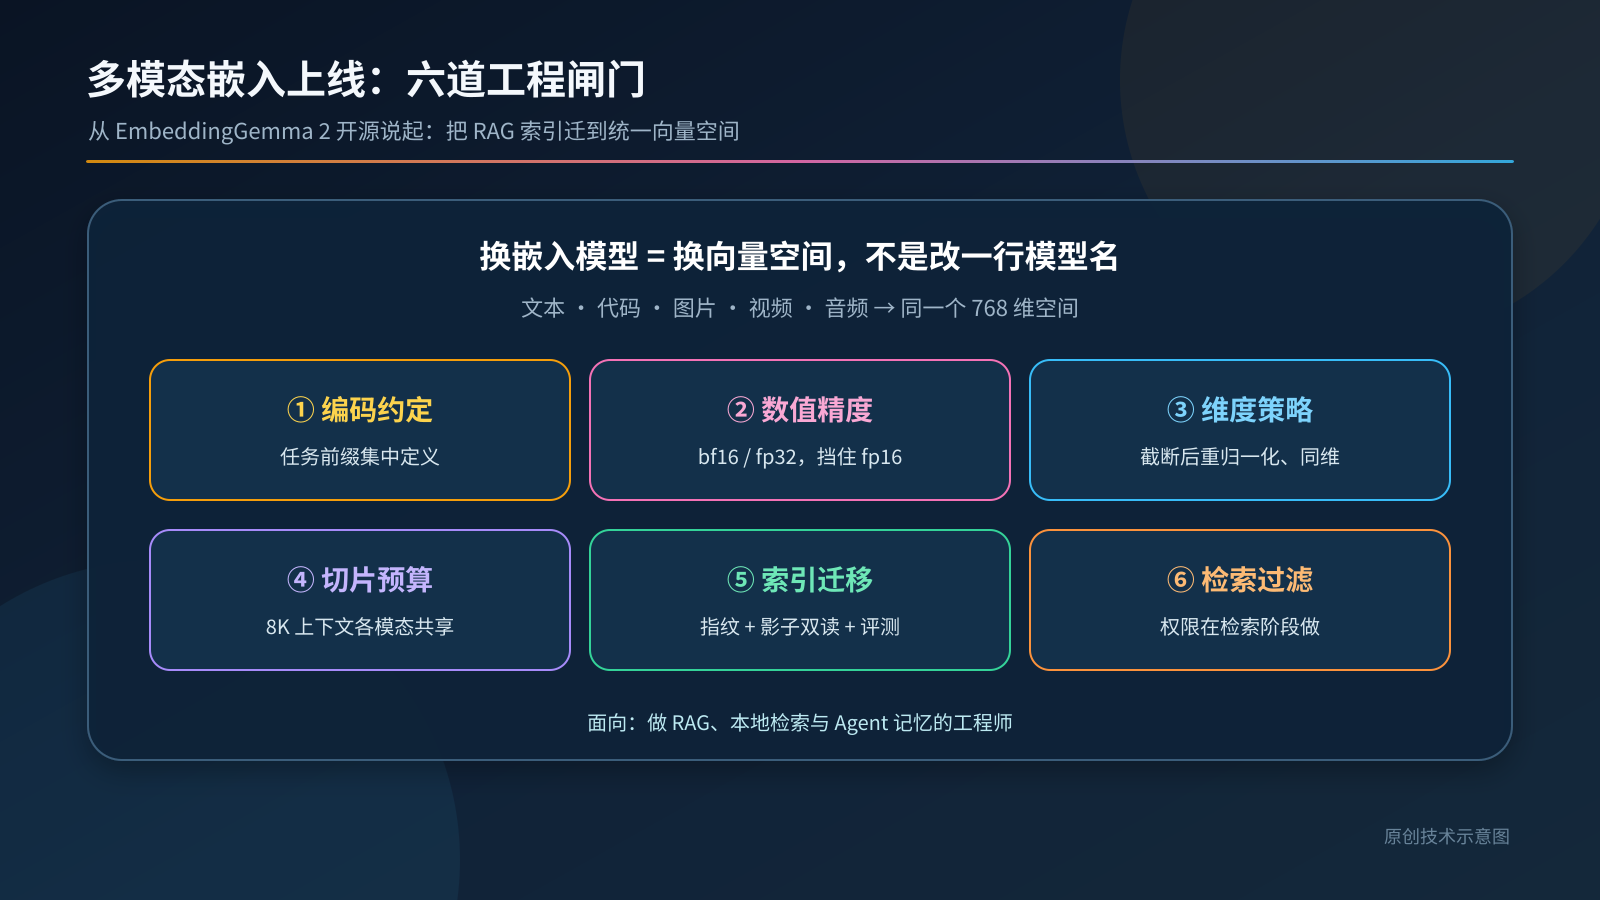
2026 年 10 月 6 日,Google DeepMind 发布了 EmbeddingGemma 2:一个 740M 参数、Apache 2.0 许可的开源嵌入模型,把文本(含代码)、图片、视频、音频映射到同一个 768 维向量空间,主打端侧运行。
对做 RAG、本地检索和 Agent 记忆的开发者来说,这条消息最容易被理解成“换个更强的嵌入模型”。实际上,多模态嵌入接进生产系统后,要改的不是一行模型名,而是索引版本、编码约定、数值精度、维度策略、切片预算和检索侧的权限过滤。本文按上线顺序,把这些改动整理成六道闸门,并给出可直接改造的代码骨架。
1. 先把公开事实和工程推论分开
| 类别 | 内容 | 出处 |
|---|---|---|
| 公开事实 | 总参数 740M:文本主干 270M(130M transformer + 140M embedder),视觉编码器 170M,音频编码器 300M,可按需加载 | 官方博客、模型卡 |
| 公开事实 | 原生输出 768 维,MRL 支持截断到 512 / 256 / 128 维 | 模型卡 |
| 公开事实 | 8,192 token 共享上下文;图片默认 280 token/张,视频 140 token/帧(默认 1 fps),音频 25 token/秒 | 模型卡 |
| 公开事实 | 文本任务要加任务前缀;query 与 document 前缀不对称;图片、视频、音频不加前缀 | 模型卡 |
| 公开事实 | 推理用 bfloat16 或 float32,不要用 float16(会出 NaN 或静默劣化) | 模型卡 |
| 公开事实 | MTEB Code 从 68.76 提升到 78.68;多语言文本 MTEB 61.36(一代 61.15) | 官方博客、模型卡 |
| 工程推论 | 换模型等于换向量空间,旧索引必须重建,不能混查 | 作者建议 |
| 工程推论 | 需要一个“编码器指纹”把模型版本、前缀、维度、精度绑进索引元数据 | 作者建议 |
下文所有阈值、分片时长、配置项名称,凡未注明出处的,都是示例值,请按自己的数据和评测结果调整。
2. 为什么不能只改模型名
嵌入模型换代,最危险的错误不是报错,而是不报错:
- 新旧模型的向量都是 768 维,形状完全兼容,向量库照样接受写入;
- 但两个模型的向量空间没有对齐关系,旧文档向量和新查询向量算出来的余弦相似度没有意义;
- 结果是召回率悄悄下降,排序看起来“还行”,线上很难第一时间发现。
所以第一原则是:索引属于某一个具体的编码器配置。模型、前缀、维度、精度、启用的模态,任何一项变了,都视为新索引。
3. 闸门一:编码约定(任务前缀)要做成代码,不要靠记忆
EmbeddingGemma 2 和一代一样,文本输入靠短前缀区分任务。检索类任务是不对称的:
- 查询:
task: search result | query: {query} - 文档:
title: {title} | text: {content},没有标题时写title: none - 代码检索:查询用
task: code retrieval | query: {query},文档的 title 位可以放文件名
模型卡特别提醒了一点:prompt_name="Document" 只会套上 title: none,有真实标题的文档需要自己拼接。而官方文档里不同页面给出的 prompt_name 写法并不完全一致(模型卡用 SearchQuery / Document,其他教程页出现过别的命名),所以别把名字硬编码在业务代码里,启动时读一次 model.prompts 做断言更稳。
# embedder.py —— 示例骨架:把前缀约定收拢到一处
from dataclasses import dataclass

QUERY_PREFIX = {
    "search": "task: search result | query: ",
    "qa": "task: question answering | query: ",
    "code": "task: code retrieval | query: ",
}

def format_doc(text: str, title: str | None = None) -> str:
    # 有标题时必须手工拼接;Document 预设只会写 title: none
    return f"title: {title or 'none'} | text: {text}"

def format_query(text: str, task: str = "search") -> str:
    return QUERY_PREFIX[task] + text
实践要点:
- 入库流水线和在线查询共用同一个模块,避免两边各写一份前缀。
- 把前缀字符串本身算进编码器指纹(见第 7 节),前缀改了就触发重建。
- 图片、视频、音频不加前缀;图文混排输入用
<|image|>、<|video|>、<|audio|>占位符标出位置。
4. 闸门二:数值精度——把 fp16 挡在门外
模型卡写得很直接:EmbeddingGemma 2 的激活范围超过 float16 的动态范围,用 fp16 推理会返回 NaN,或者返回看起来正常但已经劣化的向量。推荐在支持的硬件上用 bfloat16,其余情况(包括大多数 CPU)用 float32。
很多推理框架和量化脚本默认就是 fp16,所以这一条要写成启动检查,而不是写在文档里:
import torch, numpy as np
from sentence_transformers import SentenceTransformer

def load_embedder(model_id: str, modalities: set[str]):
    dtype = torch.bfloat16 if torch.cuda.is_available() and torch.cuda.is_bf16_supported() else torch.float32
    cfg = {}
    if "image" not in modalities and "video" not in modalities:
        cfg["vision_config"] = None
    if "audio" not in modalities:
        cfg["audio_config"] = None
    m = SentenceTransformer(model_id, model_kwargs={"torch_dtype": dtype}, config_kwargs=cfg)
    return m, str(dtype)

def health_check(m, probe_texts: list[str]):
    v = m.encode(probe_texts, normalize_embeddings=True)
    assert not np.isnan(v).any(), "embedding contains NaN: check dtype"
    norms = np.linalg.norm(v, axis=1)
    assert np.allclose(norms, 1.0, atol=1e-3), f"unexpected norms: {norms}"
config_kwargs 里置空某个编码器的写法出自模型卡的 Sentence Transformers 示例;模型卡也说明,不同推理库关闭编码器的方式不一样,换框架时要查对应文档。
5. 闸门三:维度策略——截断可以,但要重归一化、要同维
MRL 让 768 维向量可以只保留前 512 / 256 / 128 维。存储收益很直观(以下为按 float32 计算的示例,100 万条向量,不含索引结构开销):
| 维度 | 单条字节 | 100 万条约 |
|---|---|---|
| 768 | 3,072 B | 3.07 GB |
| 512 | 2,048 B | 2.05 GB |
| 256 | 1,024 B | 1.02 GB |
| 128 | 512 B | 0.51 GB |
但质量损失并不是线性的,而且多模态比纯文本掉得更厉害。下图数据取自模型卡的截断评测表:
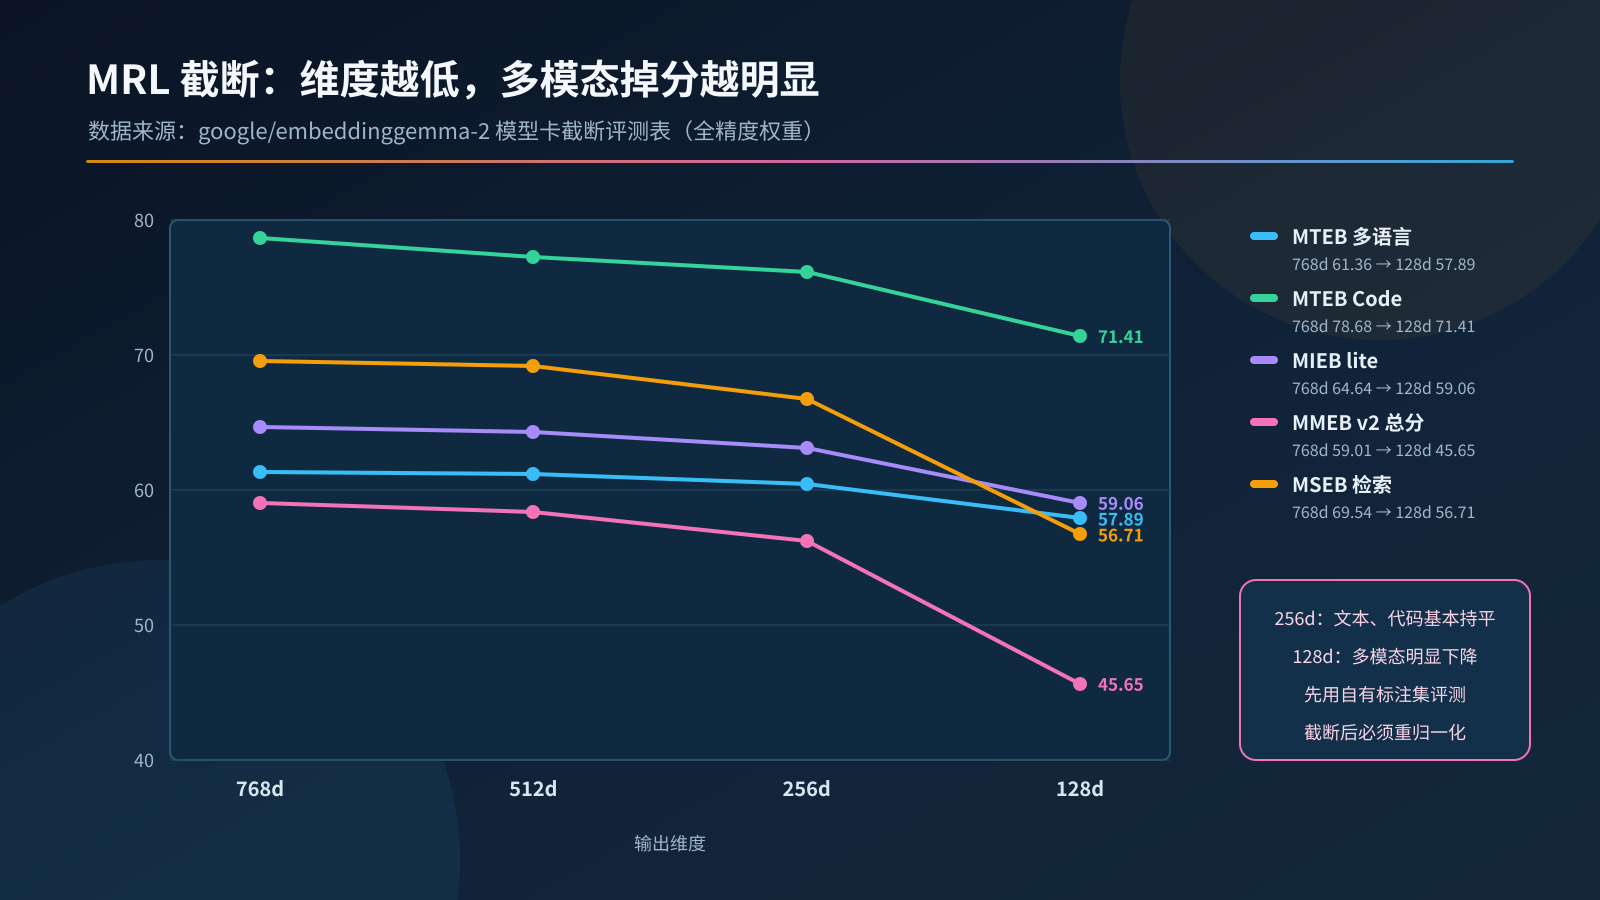
可以看到,256 维时文本和代码基本持平;降到 128 维,MMEB v2 总分从 59.01 掉到 45.65,MSEB 检索从 69.54 掉到 56.71。模型卡给的结论也是:128 维更适合纯文本,多模态场景必须用自己的数据先验证。
三条硬规则:
- 截断后必须重新 L2 归一化。直接切片的向量不是单位长度,余弦分数会“看起来合理但排序错了”。用
encode(..., truncate_dim=256, normalize_embeddings=True)让库来做。 - 查询和库必须同一维度。768 维查询不能和 128 维库比较;维度写进索引元数据,查询端从元数据读,而不是从配置文件读。
- 按模态分别选维度。纯文本知识库可以评估 256 甚至 128;含图片、视频、音频的库建议从 512 或 768 起步。
6. 闸门四:切片预算——8K 是所有模态共享的
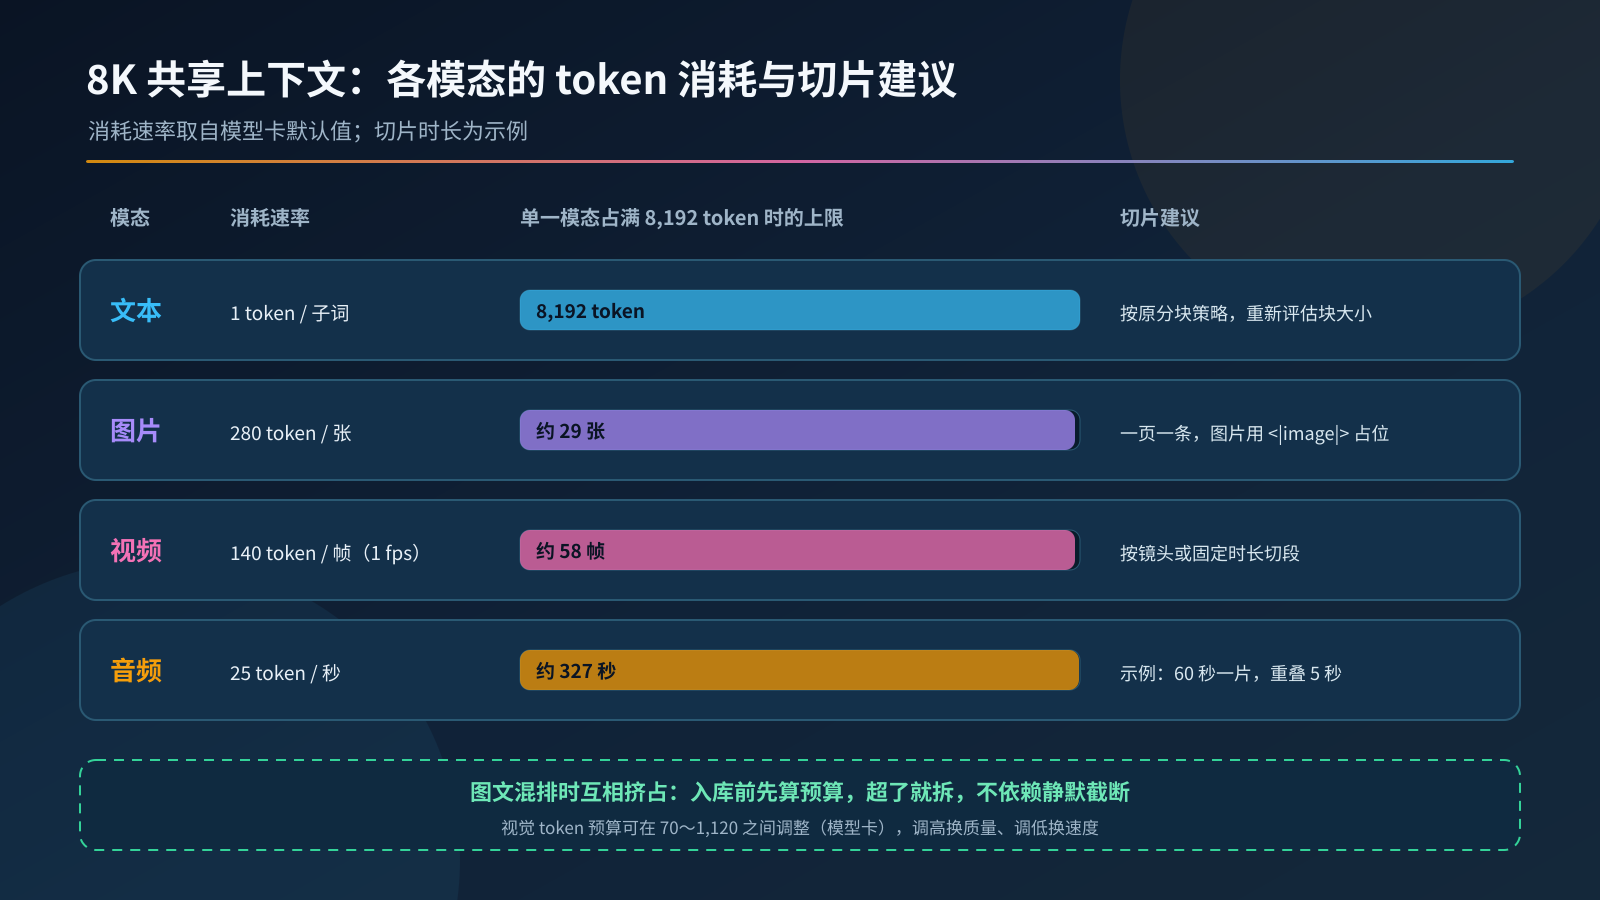
所有模态共用 8,192 token 上下文,按模型卡给出的消耗速率,单一模态的上限大约是:29 张图、58 帧视频(默认 1 fps 时约 58 秒)、约 327 秒音频。图文混排时互相挤占。
这直接决定了入库切片方式:
- 音频:按 25 token/秒算,一段 60 秒的切片约 1,500 token,留出文本描述的余量。示例:60 秒一片、前后重叠 5 秒,元数据记录
start_s/end_s,命中后可以直接跳到对应时间点。 - 视频:默认 1 fps、140 token/帧。长视频按镜头或固定时长切段,每段控制在几十帧以内;需要更细的画面理解时,模型卡说明视觉 token 预算可以在 70 到 1,120 之间调整,代价是延迟和 token 数。
- 图文页面(产品页、PDF 截图、带图的工单):一页一条,用占位符保留图片在文字中的位置,比“文字一条、图片一条”更利于跨模态召回。
- 超长文本:沿用原有分块策略即可,但要重新评估块大小,因为上下文从一代的 2K 扩到了 8K。
切片前先算预算、超了就拆,不要依赖库的静默截断:
TOKENS = {"image": 280, "video_frame": 140, "audio_s": 25}  # 模型卡默认值
CTX = 8192

def fits(n_text_tokens=0, images=0, frames=0, audio_s=0.0, reserve=256):
    used = n_text_tokens + images*TOKENS["image"] + frames*TOKENS["video_frame"] + audio_s*TOKENS["audio_s"]
    return used + reserve <= CTX, used
7. 闸门五:索引迁移——编码器指纹 + 影子双读 + 评测闸门
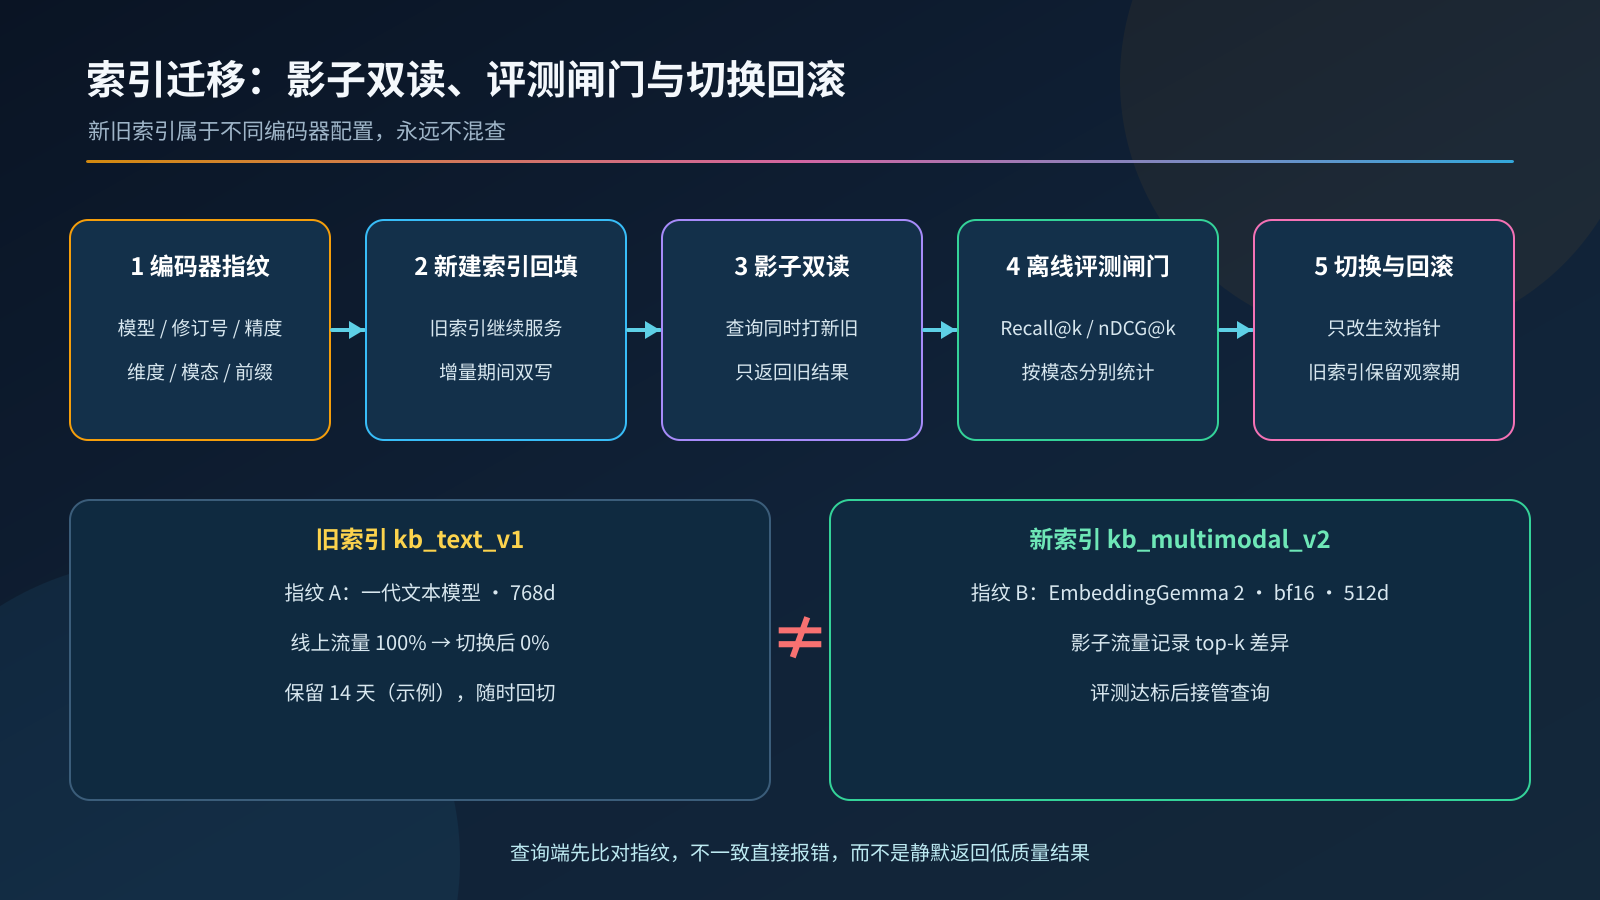
迁移流程建议拆成五步:
- 生成编码器指纹:把影响向量空间的所有因素做成一个哈希,写进每个索引(或 collection)的元数据。
- 新建索引,后台重建:旧索引继续服务,新索引全量回填;增量写入期间双写。
- 影子双读:线上查询同时打到新旧索引,只返回旧结果,记录两边 top-k 与点击、引用情况。
- 离线评测闸门:用固定的标注集(查询 → 应命中的文档/片段)比较 Recall@k、nDCG@k,按模态分开统计;达标才切流。
- 切换与回滚:切换只改“当前生效索引”指针,旧索引保留一个观察窗口。
# index_manifest.yaml —— 示例,字段名为作者建议
index: kb_multimodal_v2
embedder:
  model_id: google/embeddinggemma-2
  revision: "<pin a commit hash>"
  dtype: bfloat16
  dim: 512
  modalities: [text, image]
  query_prefix: "task: search result | query: "
  doc_template: "title: {title} | text: {content}"
fingerprint: sha256(model_id|revision|dtype|dim|modalities|query_prefix|doc_template)
cutover_gate:            # 示例阈值
  recall_at_10_min_delta: 0.0     # 新索引不得低于旧索引
  per_modality_required: true
  shadow_days: 7
rollback:
  keep_old_index_days: 14
查询端在发请求前比对指纹:
def assert_compatible(query_fp: str, index_meta: dict):
    if query_fp != index_meta["fingerprint"]:
        raise RuntimeError(
            f"embedder mismatch: query={query_fp[:12]} index={index_meta['fingerprint'][:12]}"
        )
这一步能挡住最常见的事故:某个服务升级了模型或改了维度,另一个服务还在用旧配置查询。
8. 闸门六:检索侧的权限与安全过滤
模型卡明确说明:EmbeddingGemma 2 是预训练嵌入模型,没有做后训练对齐、安全微调或输出审核,安全风险体现在下游怎么使用这些向量。对 RAG 和 Agent 来说,落到工程上是三件事:
- 权限过滤在检索阶段做:向量库查询带上租户、项目、密级等过滤条件,不要先召回再让大模型“自己别说”。
- 多模态内容同样要过审:图片里的文字、音频里的语音都会被编码进向量,被召回后可能进入生成模型的上下文。来源不可信的媒体,入库前走和文本一样的内容审查与来源标记。
- 把检索结果当作不可信输入:Agent 读到召回内容后再调用工具时,召回片段里的“指令”不应直接驱动工具调用。
9. 对 Agent 开发者的额外价值:本地代码检索和多模态记忆
两处值得单独评估:
- 代码检索:MTEB Code 提升近 10 分,加上代码检索专用前缀,适合给 Coding Agent 做本地仓库语义检索。建议用文件路径做 title,按函数或类切块,评测集直接取历史 issue 与对应修改文件。
- 端侧多模态记忆:截图、语音备忘、录屏可以和文本笔记进同一个向量空间,在本地完成“用一句话找到某段录音”。数据不出设备,但同样要做第 8 节的权限隔离,尤其是多用户共用设备的场景。
10. 上线前检查清单
- 入库与查询共用一个编码模块,前缀集中定义,有标题的文档手工拼接
- 启动时检查 dtype:只允许 bfloat16 / float32,健康检查覆盖 NaN 与向量范数
- 只加载需要的模态编码器,并确认所用推理框架的关闭方式
- 维度写入索引元数据;截断后重归一化;查询与库同维
- 多模态库不贸然用 128 维,先用自有标注集评测
- 入库切片前计算 8K 预算,音视频切片记录时间戳
- 编码器指纹覆盖模型版本、修订号、精度、维度、模态、前缀
- 新旧索引并行,影子双读 + 按模态的离线评测闸门,达标再切流
- 旧索引保留观察窗口,切换只改指针,可一键回滚
- 检索阶段做权限过滤,召回内容按不可信输入处理
参考资料
- Google Blog:EmbeddingGemma 2: an open, lightweight multimodal embedding model(2026-10-06)
- Hugging Face:google/embeddinggemma-2 模型卡
- Google AI for Developers:EmbeddingGemma 2 model card
- Google AI for Developers:Generating Embeddings with EmbeddingGemma 2 and Sentence Transformers
- Google AI for Developers:Fine-tune EmbeddingGemma 2 with Sentence Transformers
本文同步发布于 CSDN:https://blog.csdn.net/qq_29737119/article/details/167258841
- index-migration.png (152 KB)
- mrl-tradeoff.png (144 KB)
- context-budget.png (138 KB)