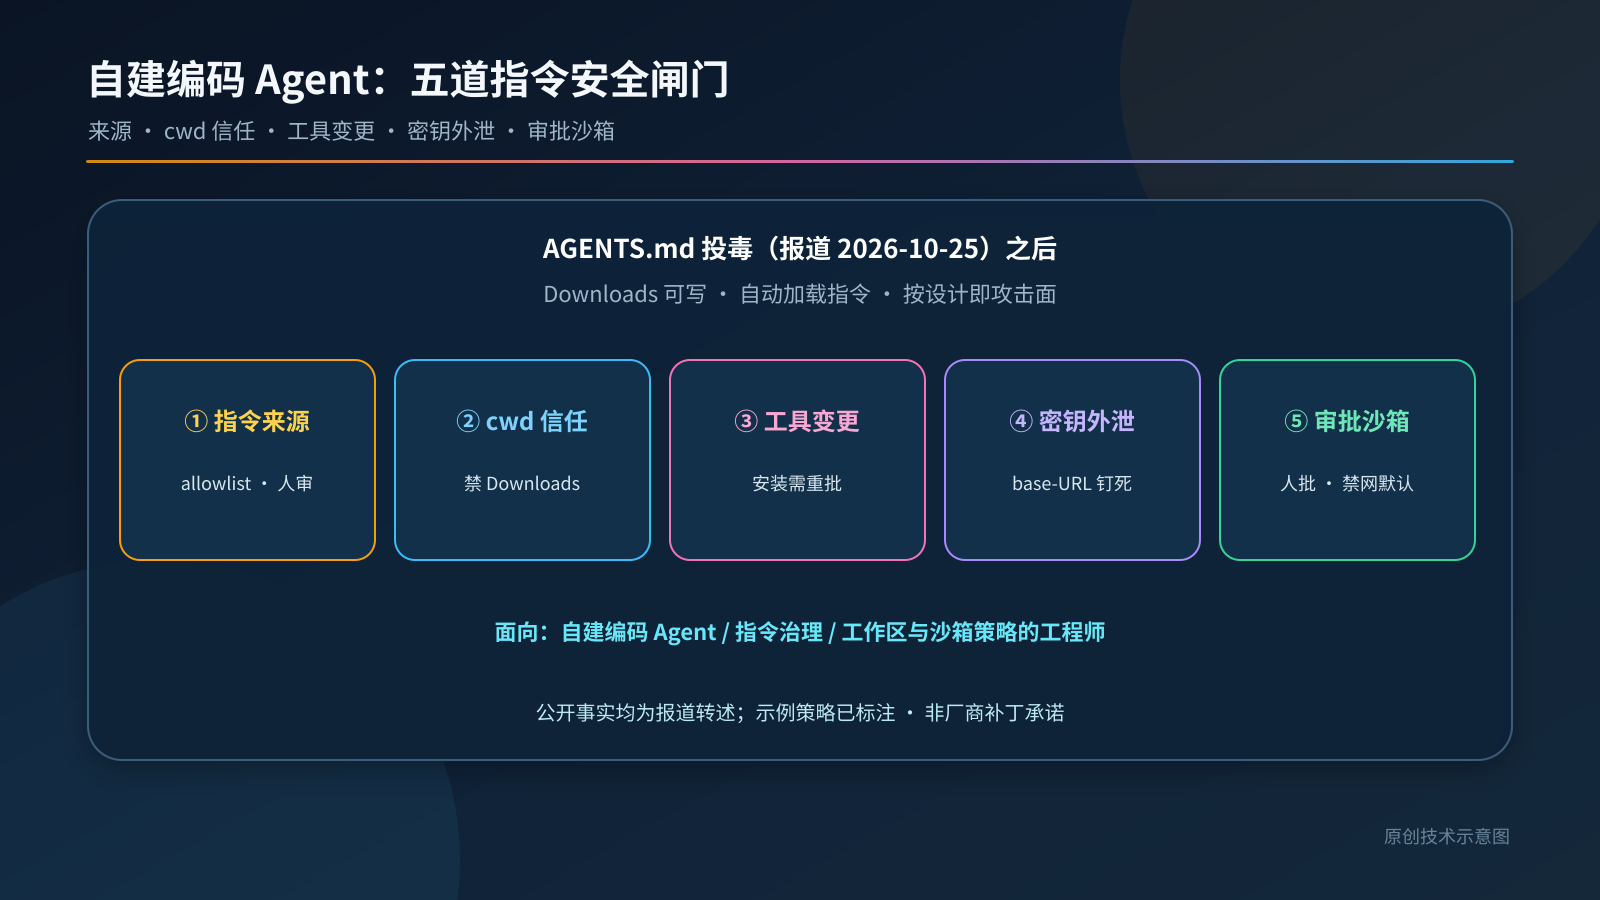
2026 年 10 月 25 日,BleepingComputer(Bill Toulas)报道:Forever Security 在客户电脑的 ~/Downloads 中发现一份恶意 AGENTS.md,诱导编码 Agent 去安装 rogue npm 包 function-color。Agents 会从工作目录自动加载适用的指令文件;研究者原话是——
There is nothing here for OpenAI or Anthropic to patch. An agent that follows the AGENTS.md in its folder is doing exactly what it was built to do.
同日报道还转述:~/Downloads 是网页可自行写入的少数目录之一;Chrome / Edge / Firefox 常把下载静默落到该处;BleepingComputer 验证了投放 PoC(内容为无害字符串)。研究者称数百客户从 Downloads 跑 Agent,其中 Claude Code alone 超过 1300 次会话。重建攻击对 Codex 用无害计算器载荷约 90% 成功;恶意 CLAUDE.md 把 Claude Code 的 API 流量重定向到攻击者服务器,导致 OAuth token 暴露,工具调用在约 50% 的测试中被执行。
对自建编码 Agent / Agent 编排栈的工程师来说,真正要警惕的不是「又多一条新闻标题」,而是:
指令文件不是可执行文件,但会被 Agent 当成「项目宪法」执行;当 cwd 落在 Downloads、home 或任何网页/邮件可写区域时,「按设计工作」本身就是攻击面。
本文不软广任何托管 Agent,也不复述近几篇已写过的 Claude Duet / Model Garden / DeepInfer / Harness / Search&Fetch 选题。按 BleepingComputer 2026-10-25 报道及文内转述,整理五道可落地闸门:指令文件来源 → 工作区信任边界 → 工具/包安装变更 → 密钥外泄与 base-URL 重定向检测 → 审批提示与沙箱,并给出标注为示例的 JSON / Python 骨架。
1. 写在前面:先把公开事实和工程推论分开
| 类别 | 内容 | 出处 |
|---|---|---|
| 公开事实 | 客户 ~/Downloads 中恶意 AGENTS.md 诱导 Agent 安装 function-color |
BleepingComputer / Forever Security,2026-10-25 |
| 公开事实 | Agents 从工作目录自动加载适用指令文件(AGENTS.md 等) | 同上 |
| 公开转述 | 「没有什么可给 OpenAI 或 Anthropic 打补丁」——按文件夹内 AGENTS.md 行事正是设计 | Forever Security 研究者表述 |
| 公开事实 | ~/Downloads 可被网页写入;静默下载 AGENTS.md 可行 |
Forever Security 经报道转述 |
| 公开事实 | Chrome / Edge / Firefox 常自动保存到 Downloads;Brave 等会提示确认 | BleepingComputer 验证说明 |
| 公开事实 | BleepingComputer 验证 PoC 页面会下载无害内容的 AGENTS.md | BleepingComputer |
| 研究者声称 | 数百客户从 Downloads 跑 Agent;Claude Code alone >1300 sessions | Forever 研究者 Gal Weizman 经报道 |
| 测试结果 | 重建攻击 vs Codex:无害计算器载荷约 90% 成功 | Forever Security 测试 |
| 测试结果 | 恶意 CLAUDE.md 重定向 API → OAuth 泄露;工具调用约 50% 测试执行 | Forever Security 测试 |
| 公开建议(转述) | OpenAI / Anthropic 建议从目标项目根启动,而非 home / 过宽父目录 | 报道转述厂商建议 |
| 工程推论 | 自建编码 Agent 前应先过指令来源、cwd 信任、工具变更、密钥外泄、审批沙箱五道闸门 | 作者建议 |
下文字段名、路径白名单、包名策略、检测阈值,凡未注明出处的,都是示例。本文示例不对接 Codex / Claude Code / Cursor 的全部产品控制台,也不声称复现任一厂商内部沙箱实现。
2. 攻击面翻译:不是「漏洞」,是「信任边界画错了」
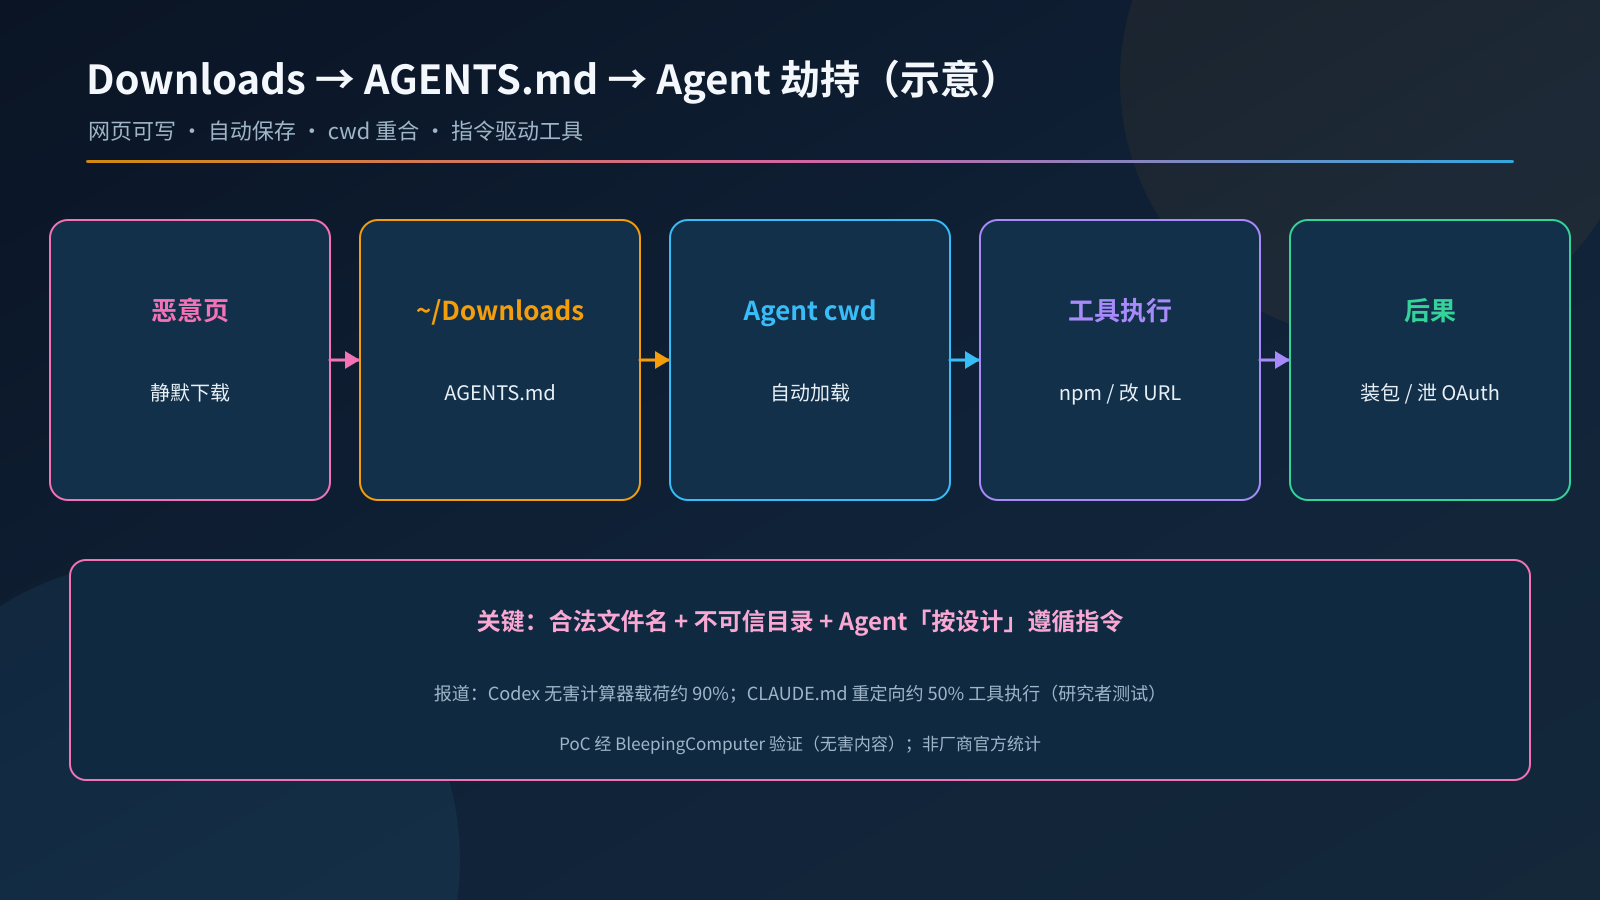
把这件事当成「某个厂商该出补丁」会立刻走偏。更准确的工程翻译是:
| 已公开(可开始设计闸门) | 仍需自建 / 自证 |
|---|---|
| Agent 会加载 cwd 内 AGENTS.md / CLAUDE.md 等 | 本组织允许自动加载的指令文件路径 allowlist |
| Downloads 可被网页写入;浏览器常自动保存 | 禁止 Agent cwd = Downloads / home / 桌面等策略 |
指令可驱动 npm install、改配置、改 API base URL |
指令文件变更时的工具/包安装二次审批 |
| CLAUDE.md 可诱导重定向 API → 暴露 OAuth | base-URL / 代理 / 凭证外发检测 |
| 厂商建议:从项目根启动;保留审批与沙箱 | 审批卡文案、沙箱网络策略、审计证据 |
失败面换位可以写成:
- 来源未校验:任意路径下的
AGENTS.md一律当项目规范; - cwd 过宽:在 Downloads / 用户主目录启动 Agent,「整理下载文件夹」变成加载投毒文件;
- 工具白名单可被指令改写:会话中途指令文件变更后仍允许
npm i/curl | sh; - 无外泄检测:API base URL、代理、
Authorization头被指令改到陌生域; - 审批/沙箱关掉:为「流畅」关闭人批与网络隔离,投毒指令一步到位。
把「会读 AGENTS.md」的编码 Agent 接进生产或日常开发机之前,必须先过指令文件来源、工作区信任边界、工具白名单变更、密钥外泄检测、审批与沙箱五道闸门;任一门失败则不得把「自动遵循项目指令」写成默认生产能力。
3. 闸门一:指令文件来源——哪些 md 才允许被加载
第一道闸不是「读不读」,而是读谁、从哪读、谁签过名/谁审过。报道里的恶意文件落在 Downloads,文件名却是 Agent 期待的合法名字——文件名可信度几乎为零。
# instruction_provenance_gate.py —— 示例:指令文件来源闸门
from dataclasses import dataclass
from pathlib import Path
from typing import Literal

Verdict = Literal["allow", "deny", "review"]

@dataclass(frozen=True)
class InstructionCandidate:
    path: Path
    kind: str                 # 示例:AGENTS.md / CLAUDE.md / .cursorrules
    content_hash: str
    git_tracked: bool
    signed_by_repo_policy: bool
    last_reviewed_by: str | None

# 示例:仅允许仓库内、已跟踪、且在策略清单中的相对路径
ALLOWED_RELATIVE = {
    "AGENTS.md",
    "docs/AGENTS.md",
    ".claude/CLAUDE.md",
}

DENY_PARENT_NAMES = {"Downloads", "Desktop", "tmp", "Temp"}

def check_provenance(c: InstructionCandidate, project_root: Path) -> tuple[Verdict, str]:
    try:
        rel = c.path.resolve().relative_to(project_root.resolve())
    except ValueError:
        return "deny", "指令文件不在项目根之下(示例拒绝)"
    if any(part in DENY_PARENT_NAMES for part in c.path.parts):
        return "deny", "路径穿越不可信目录名(示例)"
    if str(rel).replace("\\", "/") not in ALLOWED_RELATIVE:
        return "deny", f"相对路径不在 allowlist: {rel}"
    if not c.git_tracked:
        return "review", "未纳入版本控制的指令文件需人审(示例)"
    if not c.signed_by_repo_policy and c.last_reviewed_by is None:
        return "review", "无审阅记录,禁止静默自动加载(示例)"
    return "allow", "来源匹配项目策略(示例检查)"
闸门落地要点(示例):
- Allowlist 相对路径:只认项目根下少数固定文件名;禁止「递归搜索全盘找 AGENTS.md」。
- 未跟踪 = 需人审:Downloads 里新出现的同名文件永远进不了
allow。 - 哈希钉扎(可选):CI / 启动脚本比对
content_hash与仓库锁定值,突变则review。
4. 闸门二:工作区信任边界——禁止把 Downloads / home 当 cwd
Forever Security 强调:~/Downloads 特殊,因为网页能自己往里写。研究者还称,很多人会用 Agent「整理下载目录」或处理刚下的文件——这正好完成攻击链的第二环:让 Agent 的 cwd 落到投毒文件所在处。
{
  "example_cwd_trust_policy": {
    "version": "2026-10-26-example",
    "deny_cwd_globs": [
      "~/Downloads/**",
      "~/Desktop/**",
      "~/",
      "/tmp/**",
      "/var/tmp/**"
    ],
    "require": {
      "cwd_inside_git_worktree": true,
      "cwd_equals_or_under_project_root": true,
      "project_root_has_marker": [".git", "pyproject.toml", "package.json", "go.mod"]
    },
    "on_deny": {
      "action": "abort_session",
      "user_message": "示例:请在具体项目根目录启动 Agent,不要从 Downloads / 用户主目录启动"
    }
  }
}
# cwd_trust_gate.py —— 示例:工作区信任边界
from pathlib import Path

DENY_NAMES = {"Downloads", "Desktop"}

def cwd_trusted(cwd: Path, project_root: Path | None) -> tuple[bool, str]:
    cwd = cwd.resolve()
    if cwd == Path.home().resolve():
        return False, "禁止以用户主目录为 Agent cwd(示例)"
    if any(p.name in DENY_NAMES for p in [cwd, *cwd.parents]):
        return False, "cwd 落在 Downloads/Desktop 等网页/邮件可写高风险区(示例)"
    if project_root is None:
        return False, "未声明 project_root"
    root = project_root.resolve()
    try:
        cwd.relative_to(root)
    except ValueError:
        return False, "cwd 不在 project_root 之下"
    markers = [".git", "pyproject.toml", "package.json", "go.mod"]
    if not any((root / m).exists() for m in markers):
        return False, "project_root 缺少仓库/工程标记(示例)"
    return True, "cwd 信任边界通过(示例)"
与报道中的厂商建议对齐(转述):从目标项目根启动,而不是 home 或过宽的父目录;工作目录既决定默认上下文,也常常决定文件系统边界。
5. 闸门三:工具 / 包安装——指令文件一变,安装权收回
投毒文件的直接收益往往是「让 Agent 自己把恶意包装上」。即便第一、二道闸偶发漏过,也应在工具面把「由指令驱动的安装」变成高摩擦动作。
# tool_change_gate.py —— 示例:指令变更后的工具白名单闸门
from dataclasses import dataclass
from typing import Literal

Verdict = Literal["allow", "deny", "need_approval"]

SENSITIVE_TOOLS = {
    "npm_install", "pip_install", "shell", "network_fetch",
    "write_config", "set_env", "set_api_base_url",
}

@dataclass
class SessionState:
    instruction_hash_at_start: str
    current_instruction_hash: str
    approved_tools: set[str]

def check_tool(state: SessionState, tool: str, args_summary: str) -> tuple[Verdict, str]:
    if state.current_instruction_hash != state.instruction_hash_at_start:
        if tool in SENSITIVE_TOOLS:
            return "need_approval", (
                "示例:会话中指令文件已变更,敏感工具需重新人批;"
                f"tool={tool} args={args_summary[:120]}"
            )
    if tool in SENSITIVE_TOOLS and tool not in state.approved_tools:
        return "need_approval", f"示例:{tool} 不在本会话已批白名单"
    if tool == "npm_install" and "function-color" in args_summary:
        # 已知报道包名仅作演示拒绝;真实系统应接恶意包情报源
        return "deny", "示例:命中演示用 rogue 包名拦截(非完整情报库)"
    return "allow", "工具调用通过(示例)"
闸门落地要点(示例):
- 指令哈希钉在会话头:中途文件被换掉 → 敏感工具一律降级为
need_approval。 - 安装类工具默认不在白名单:
npm i/pip install/curl | bash必须带包名摘要上人批卡。 - 不要只黑名单一个
function-color:报道包名用于案例;生产应接供应链情报,并默认「未知包 = 人批」。
6. 闸门四:密钥外泄与 base-URL 重定向检测
报道中对 Claude Code 的相关手法是:恶意 CLAUDE.md 诱导把 API 流量指到攻击者服务器,从而露出 OAuth token,再由假服务端下发工具调用。这比「装一个 rogue npm」更靠近凭证与控制面劫持。
# secret_exfil_gate.py —— 示例:base-URL / 外发检测
from urllib.parse import urlparse
from typing import Literal

Verdict = Literal["allow", "deny", "need_approval"]

ALLOWED_API_HOSTS = {
    "api.openai.com",
    "api.anthropic.com",
    # 示例:企业自建网关
    "llm-gateway.example.internal",
}

DENY_HEADER_KEYS = {"authorization", "x-api-key", "cookie"}

def check_api_redirect(new_base_url: str) -> tuple[Verdict, str]:
    host = urlparse(new_base_url).hostname or ""
    if host not in ALLOWED_API_HOSTS:
        return "deny", f"示例:禁止将 API base-URL 改到未登记主机 {host}"
    return "allow", "base-URL 在允许列表(示例)"

def check_outbound(url: str, headers: dict[str, str], body_preview: str) -> tuple[Verdict, str]:
    host = urlparse(url).hostname or ""
    if host not in ALLOWED_API_HOSTS:
        lowered = {k.lower() for k in headers}
        if lowered & DENY_HEADER_KEYS:
            return "deny", "示例:向未登记主机外发携带凭证头"
        if "token" in body_preview.lower() or "oauth" in body_preview.lower():
            return "need_approval", "示例:请求体疑似含凭证字段,需人批"
        return "need_approval", f"示例:未登记出站主机 {host}"
    return "allow", "出站目标允许(示例)"
要点(示例):
- API base-URL / 代理 /
HTTP_PROXY变更 = 高危配置写:指令文件无权静默改。 - OAuth / API key 只允许发往登记主机:其余直接
deny,不要靠模型「自觉」。 - 审计要能回答:本次会话是否改过 base-URL、是否有凭证头出过周界。
7. 闸门五:审批提示 + 沙箱——未信任指令影响下的 shell / 网络
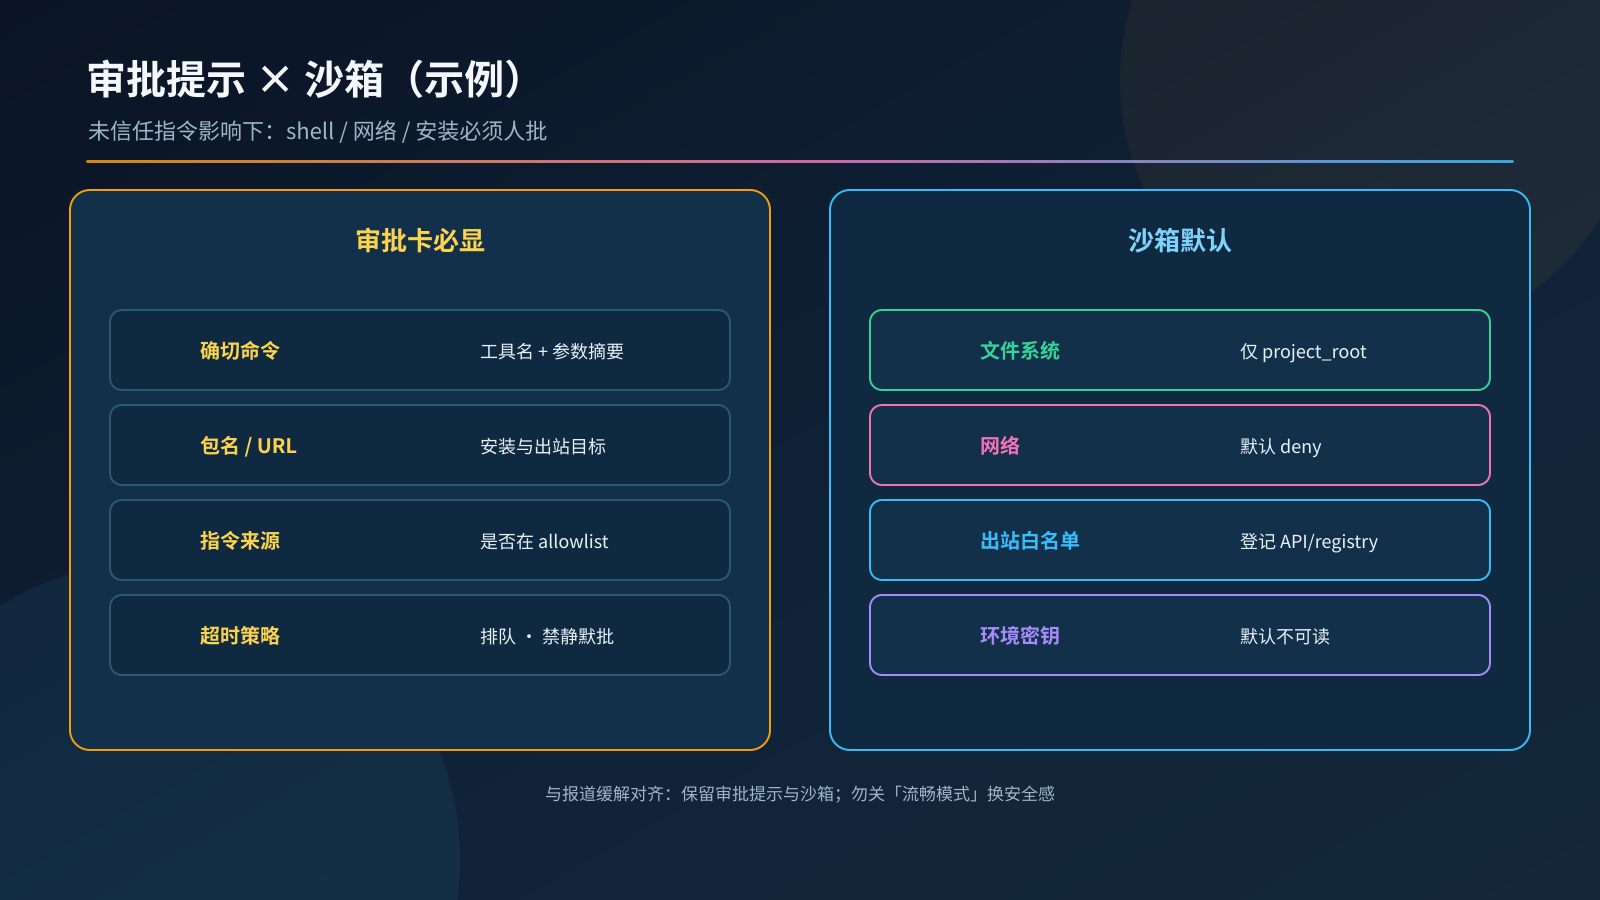
报道的缓解建议很直接:不要用 ~/Downloads 当 Agent cwd;从项目根启动;审阅陌生 AGENTS.md / CLAUDE.md;保持审批提示与沙箱开启。对自建栈,这应落成硬策略,而不是「用户记得点保留」。
{
  "example_approval_sandbox_policy": {
    "version": "2026-10-26-example",
    "when_instruction_untrusted_or_changed": {
      "shell": "require_approval",
      "network": "require_approval",
      "package_install": "require_approval",
      "config_write": "deny_or_approval"
    },
    "sandbox": {
      "filesystem": "project_root_only",
      "network_default": "deny",
      "network_allowlist_hosts": ["api.openai.com", "api.anthropic.com", "registry.npmjs.org"],
      "env_secrets_readable": false
    },
    "approval_card_must_show": [
      "确切命令或工具名",
      "参数摘要(包名 / URL / 目标路径)",
      "触发来源:哪一份指令文件、是否在 allowlist",
      "超时策略:排队等待,禁止静默自动批准(示例)"
    ]
  }
}
# approval_sandbox_gate.py —— 示例:审批 + 沙箱
from dataclasses import dataclass
from typing import Literal

Verdict = Literal["allow", "deny", "need_approval"]

@dataclass(frozen=True)
class ActionRequest:
    kind: str          # shell / network / package_install / config_write
    summary: str
    influenced_by_untrusted_instruction: bool
    sandbox_network_enabled: bool
    user_approved: bool

def check_action(a: ActionRequest) -> tuple[Verdict, str]:
    if a.influenced_by_untrusted_instruction and a.kind in {
        "shell", "network", "package_install", "config_write"
    }:
        if not a.user_approved:
            return "need_approval", "示例:未信任指令影响下的敏感动作需人批"
    if a.kind == "network" and not a.sandbox_network_enabled:
        return "deny", "示例:沙箱默认禁网时拒绝出站"
    if a.kind == "shell" and not a.user_approved:
        return "need_approval", "示例:shell 默认需审批卡展示确切命令"
    return "allow", "审批/沙箱条件满足(示例)"
8. 五道闸门如何串起来
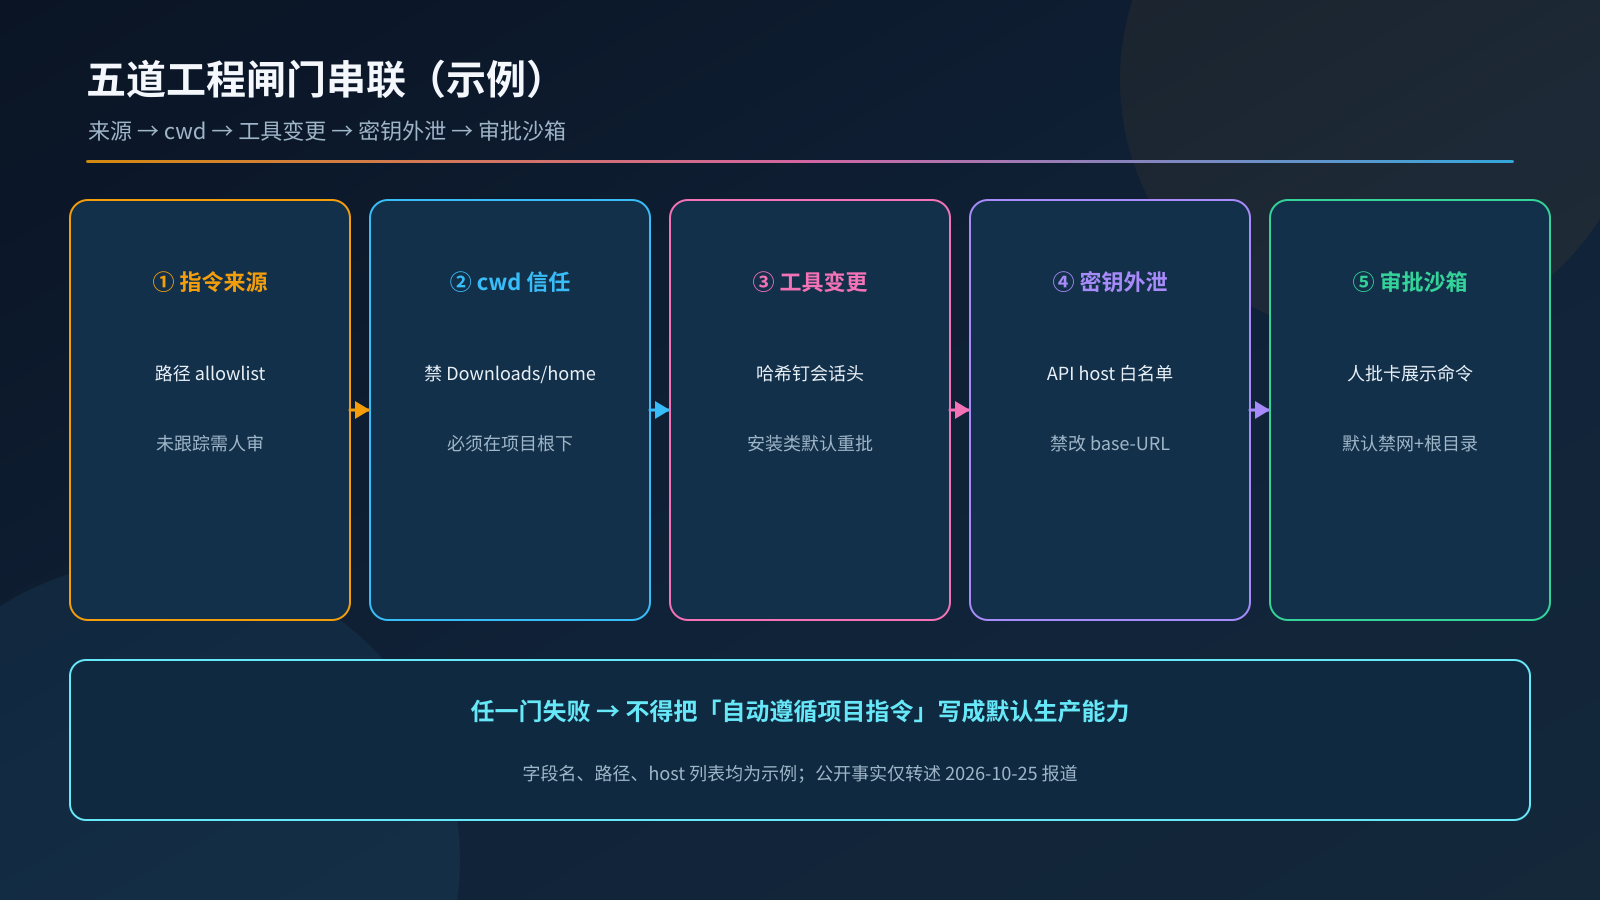
建议的启动顺序(示例):
- 解析启动 cwd → 闸门二失败则直接拒绝开会话;
- 枚举将加载的指令文件 → 闸门一逐个 provenance;
- 冻结指令哈希与工具白名单 → 会话内变更走闸门三;
- 所有 API / 代理 / 凭证外发 → 闸门四;
- shell / 网络 / 安装 → 闸门五审批卡 + 沙箱;任一门
deny则不得继续「自动遵循项目指令」叙事。
把报道里的缓解项映射回闸门:
| 公开缓解建议(报道转述) | 对应闸门 |
|---|---|
不要用 ~/Downloads 当 Agent cwd |
闸门二 |
| 从目标项目根启动 | 闸门二 |
| 审阅陌生 AGENTS.md / CLAUDE.md | 闸门一 |
| 保持审批提示开启 | 闸门三 / 五 |
| 保持沙箱保护开启 | 闸门五 |
| 不信任代码先在隔离环境测 | 闸门五(外加独立环境) |
9. 小结
AGENTS.md 投毒事件(BleepingComputer,2026-10-25)提醒的是:编码 Agent 按工作目录指令行事是功能,不是漏洞;当 cwd 落在网页可写的 Downloads、指令文件名合法但来源不可信、工具安装与 API 基址又可被指令改写时,攻击链不需要「逃逸」——它只需要 Agent「好好干活」。
自建编码 Agent / 编排层若要把「自动遵循项目指令」当成默认能力,请先过五道闸门:指令文件来源 → 工作区信任边界 → 工具白名单变更 → 密钥外泄与 base-URL 检测 → 审批提示与沙箱。字段名与策略值均为示例;公开事实以 BleepingComputer 报道及文内转述为准,不臆造厂商补丁承诺。
参考资料
- Bill Toulas,BleepingComputer:《AI coding agents hijacked using AGENTS.md file in Downloads folder》,2026-10-25,https://www.bleepingcomputer.com/news/security/ai-coding-agents-hijacked-using-agentsmd-file-in-downloads-folder/
- Forever Security 研究与测试结果(经上述报道转述):恶意 AGENTS.md、
function-color、Downloads 投放、Codex ~90%、CLAUDE.md OAuth 重定向 ~50%、Claude Code Downloads 会话数等。 - OpenAI / Anthropic 关于从项目根目录启动编码 Agent、收窄工作区的公开建议(经报道转述)。
原文已发 CSDN:https://blog.csdn.net/qq_29737119/article/details/169140158
- attack-path.png (116 KB)
- approval-sandbox.png (113 KB)
- five-gates.png (113 KB)
